Midjourney v6, OpenAI DALL-E 3, Stable Diffusion XL, Flux.1, Google Imagen과 같은 생성형 인공지능의 급격한 발전으로 인해 사진과 구별하기 어려운 정교한 이미지를 순식간에 만들어낼 수 있게 되었습니다.
이러한 기술적 도약은 창작의 영역을 획기적으로 넓혔지만, 가짜 뉴스의 확산, 딥페이크 사기, 스톡 이미지 오염, 저작권 분쟁 등 중대한 사회적 문제를 야기하고 있습니다.
이러한 문제에 대처하고자 ImageSizeFinder는 완전 개방형 **무료 AI 이미지 탐지기**를 선보였습니다. 근거 없는 확률 수치만 제시하며 유료 구독을 유도하는 기존 도구들과 달리, 당사 서비스는 개인정보 보호를 최우선으로 하는 듀얼 레이어 탐지 아키텍처를 기반으로 합니다. 모든 핵심 분석은 사용자의 브라우저 내부에서 결정론적으로 실행되며, 투명하고 검증 가능한 객관적 증거를 제공합니다.
본 가이드에서는 핵심 기능, 검출 아키텍처, 수학적 알고리즘 원리 및 실제 사용 시 유의해야 할 한계점을 상세히 설명합니다.
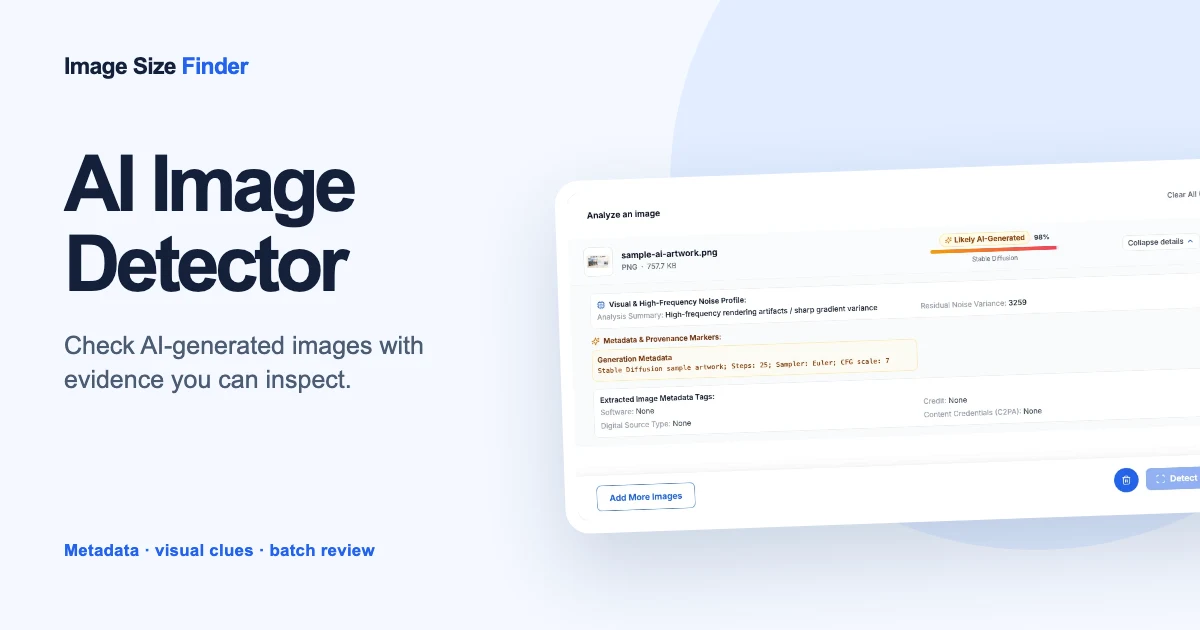 그림 1: 멀티 소스 입력, 일괄 배치 분석 및 로컬 개인정보 보호 검증을 지원하는 ImageSizeFinder 무료 AI 이미지 탐지기 인터페이스.
1. AI 이미지 탐지기의 주요 기능
속도, 프라이버시, 분석적 엄밀함을 고루 충족하도록 설계되었습니다:
- 100% 무료 및 무제한 사용: 회원가입, 신용카드 등록, 인위적인 일일 스캔 제한 없이 브라우저 내 로컬 분석을 무제한으로 이용할 수 있습니다.
- 클라이언트 측 개인정보 보호 (Zero-Upload): 메타데이터 추출과 픽셀 노이즈 분석이 WebAssembly와 HTML5 Canvas API를 통해 사용자 브라우저 내부에서만 실행됩니다. 클라우드 분석을 명시적으로 선택하지 않는 한 이미지가 외부 서버로 전송되지 않습니다.
- 다양한 이미지 입력 방식:
- 단일 또는 다중 파일 드래그 앤 드롭.
- 파일 탐색기를 통한 직접 선택.
- 클립보드 즉시 붙여넣기: 페이지 어디서나
Ctrl+V(macOS는Cmd+V)를 눌러 캡처 이미지를 즉시 분석. - 이미지 직접 URL 입력:
https://링크를 붙여넣어 다운로드 없이 웹 이미지를 바로 검사.
- 통합 배치 작업 공간: 수십 장의 이미지를 한 번에 등록하고, 상태와 썸네일을 목록에서 확인하며 클릭 한 번으로 일괄 스캔 실행.
- 투명한 증거 내역 제공: 검사된 카드를 펼치면 소프트웨어 서명, IPTC 출처 태그, 프롬프트 생성 파라미터, 잔차 노이즈 분산 수치 등 구체적인 판별 근거를 확인할 수 있습니다.
2. 감지 아키텍처: 2단계 점진적 파이프라인
단일 지표만으로는 AI 생성 여부를 완벽히 판별하기 어렵습니다. 메타데이터는 삭제될 수 있고, 압축을 거치면 픽셀 패턴이 왜곡되기 때문입니다.
이에 따라 당사 시스템은 계층형 듀얼 레이어 파이프라인을 적용합니다:
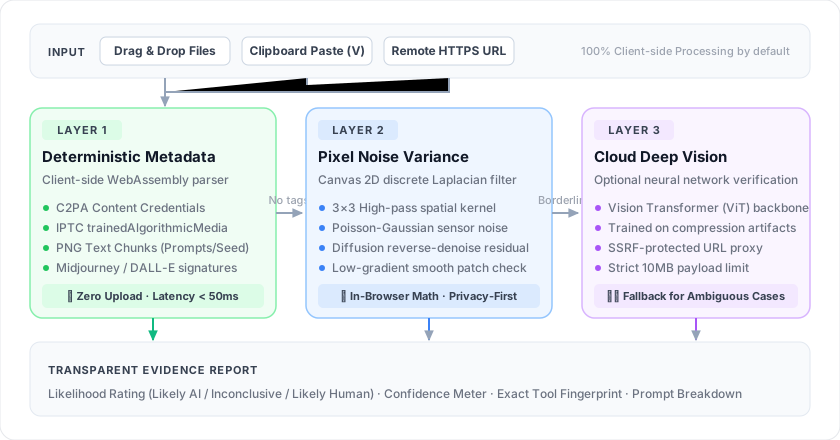 그림 2: 3단계 점진적 아키텍처: WebAssembly 기반 결정론적 메타데이터 고속 스캔, Canvas 고주파 픽셀 노이즈 합성곱 연산, 선택적 클라우드 신경망 비전 검증.
3. 구현 세부 사항: 레이어별 작동 방식
레이어 1: 결정론적 메타데이터 및 출처 추적 분석
많은 AI 생성 도구는 결과물 저장 시 소프트웨어 규격에 따른 마커를 남깁니다. 1단계에서는 고성능 바이너리 파싱 라이브러리(ExifReader)를 통해 바이트 스트림을 빠르게 스캔합니다:
- IPTC Digital Source Type:
- 국제 표준 메타데이터 필드로, AI 생성물은
trainedAlgorithmicMedia또는compositeSynthetic으로 표기됩니다. - Google Imagen, Adobe Firefly 등이 이 필드를 기본 기록합니다.
- 국제 표준 메타데이터 필드로, AI 생성물은
- IPTC Credit 및 Software 태그:
- Midjourney 웹 출력물은
Credit또는Software필드에Midjourney텍스트를 기재합니다. - DALL-E 3 역시 OpenAI의 고유 생성 식별자를 포함합니다.
- Midjourney 웹 출력물은
- PNG 텍스트 청크 (
tEXt,iTXt,zTXt):- Stable Diffusion 환경(Automatic1111, ComfyUI, Forge)은 PNG 헤더에 전체 생성 매개변수를 저장합니다.
- 긍정/부정 프롬프트, 시드(Seed), CFG Scale, 샘플러, LoRA 모델명 등을 완전하게 추출합니다.
- C2PA (콘텐츠 출처 및 진위 연합):
- Content Authenticity Initiative 규격에 따라 JUMBF 포맷으로 암호화 서명된 출처 증명 컨테이너(
c2pa박스) 유무를 스캔합니다.
- Content Authenticity Initiative 규격에 따라 JUMBF 포맷으로 암호화 서명된 출처 증명 컨테이너(
이 레이어에서 확실한 증거가 발견되면, 복잡한 연산 없이 즉시 **높은 신뢰도(High Confidence)**로 판정합니다.
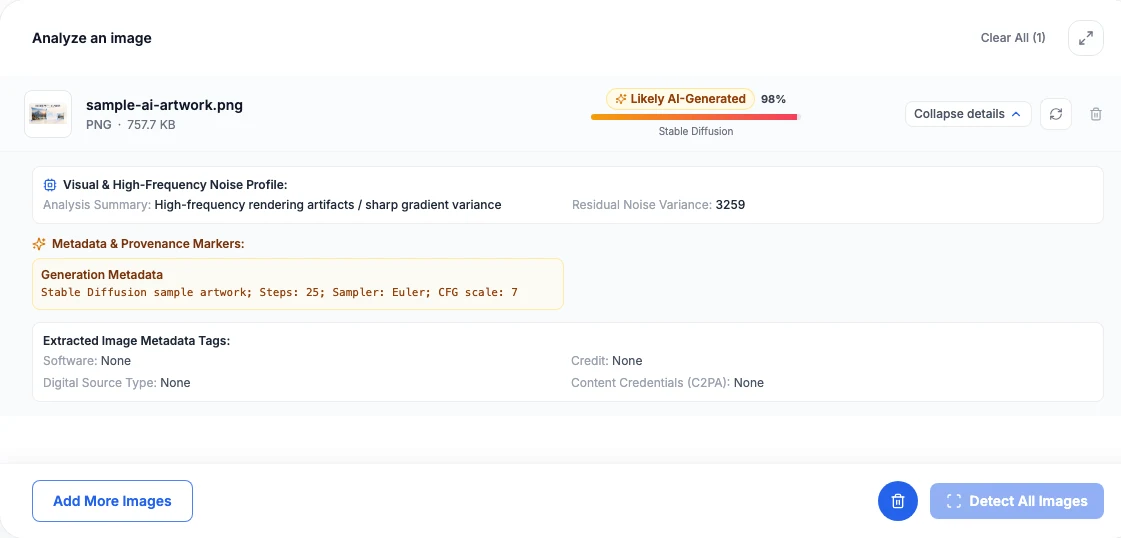 그림 3: 검출된 모델 생성 파라미터(단계, 샘플러, CFG)와 노이즈 분산 수치가 투명하게 표시된 증거 내역 화면.
레이어 2: 브라우저 로컬 픽셀 고주파 노이즈 분산 분석
메타데이터가 유실된 이미지(JPEG 변환 또는 외부 도구에 의한 메타데이터 삭제)의 경우, 브라우저는 OffscreenCanvas와 HTML5 Canvas API를 활용해 공간 필터링 분석을 진행합니다.
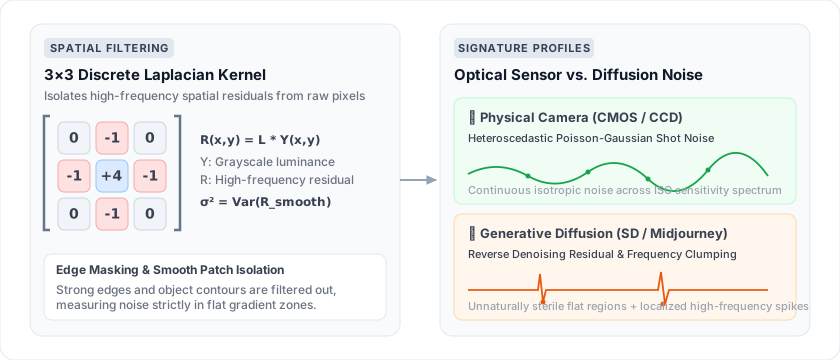 그림 4: 3x3 라플라시안 이산 고역 통과 합성곱 필터를 통한 고주파 잔차 R(x, y) 분리. 광학 센서 샷 노이즈와 확산 모델 역디노이징 잔차의 통계적 대비.
물리적 및 수학적 원리
- 실제 카메라 센서: 광학 센서(CMOS/CCD)는 광자를 받아들일 때 광자 샷 노이즈와 열잡음의 영향을 받아 **포아송-가우스 분포(Poisson-Gaussian Shot Noise)**를 따릅니다. 균일한 노출 영역에서 실제 센서 노이즈는 통계적으로 균일하고 등방적인 특성을 지닙니다.
- 확산 생성 모델 (Diffusion Models): Stable Diffusion이나 Midjourney 등은 가우스 노이즈로부터 단계적 역디노이징(Reverse Denoising)을 통해 이미지를 생성합니다. 이 과정에서 미세 픽셀 단위에 특유의 공간 자기상관이 남으며, 평탄한 면은 지나치게 매끄럽고 텍스처 부위에는 비정상적인 고주파 에너지가 집중됩니다.
알고리즘 수행 단계
- 무손실 상태로 이미지를
OffscreenCanvas에 렌더링. getImageData를 호출하여 흑백 밝기 행렬Y(x, y)추출.- 3x3 이산 라플라시안 필터를 적용하여 고주파 잔차
R(x, y)분리:┌ ┐ │ 0 -1 0 │ │ -1 4 -1 │ │ 0 -1 0 │ └ ┘ - 강한 윤곽선을 제외한 평탄 영역에서 잔차 분산
σ²계산:σ² = (1/N) · Σ (Rᵢ − R̄)² - 분산 수치 및 주파수 에너지 분포를 실제 광학 센서 벤치마크 데이터베이스와 대조.
이 연산은 순수 자바스크립트로 브라우저에서 직접 실행되므로 이미지당 50~150ms 만에 완료되며 네트워크 지연이 발생하지 않습니다.
레이어 3: 클라우드 딥 비전 엔진 (선택적)
메타데이터가 없고 로컬 노이즈 수치가 임계치 경계에 걸쳐 있는 경우, 선택적 클라우드 심층 모델을 활용할 수 있습니다:
- 방대한 실사 및 생성 데이터셋으로 압축 내성 학습을 마친 Vision Transformer 기반 아키텍처.
- 외부 URL 분석 시 SSRF 방어, 이미지 형식 검증, 10MB 크기 제한을 적용한 보안 프록시를 통해 안전하게 처리.
4. 탐지 도구의 한계 및 주의사항
어떤 AI 탐지 도구도 100% 무결할 수는 없습니다. 결과를 해석할 때는 다음 사항을 반드시 고려해야 합니다:
1. 소셜 미디어 플랫폼의 메타데이터 삭제
카카오톡, 인스타그램, X(트위터) 등은 업로드 시 트래픽 절감과 프라이버시 보호를 위해 모든 EXIF, IPTC, C2PA 메타데이터를 강제로 삭제합니다. SNS에서 내려받은 이미지는 1단계 메타데이터 추적이 불가능합니다.
2. 강력한 재압축 및 후가공
블러 필터 적용, 두터운 필름 그레인 오버레이, 과도한 JPEG 압축(품질 60 이하)은 미세 픽셀 구조를 훼손하여 판별 정확도를 떨어뜨릴 수 있습니다.
3. 디지털 일러스트 및 3D 렌더링
디지털 드로잉이나 3D 그래픽(Blender, Unreal Engine)은 물리 카메라 센서 노이즈가 애초에 존재하지 않습니다. 이러한 매끄러움이 인공적인 신호로 해석될 수 있으므로 창작 맥락을 감안해야 합니다.
4. 비공개 잠재 공간 워터마크 (SynthID 등)
확산 모델의 잠재 공간에 직접 삽입되는 비가시 워터마크(Google DeepMind의 SynthID 등)는 전용 키와 검증 서버가 필요하여 브라우저에서 오프라인으로 판별할 수 없습니다.
💡 권장 사항: AI 탐지 결과는 판단을 돕는 유력한 보조 증거로 활용하세요. 중요한 사안일수록 이미지의 출처, 손가락 묘사, 조명과 그림자의 물리적 일관성 등을 복합적으로 교차 검증하는 것이 바람직합니다.
5. 지금 바로 테스트해보기
이미지를 직접 확인해보고 싶으신가요?
- **무료 AI 이미지 탐지기**로 이동합니다.
- 이미지를 끌어다 놓거나, 클립보드에서 붙여넣거나, URL을 입력합니다.
- 실시간으로 판별된 AI 확률 배지와 신뢰도 지표를 확인하고, 상세 증거 패널을 열어 메타데이터와 노이즈 분석 수치를 살펴보세요.
참고 자료 및 기술 문서
- 01.ExifReader — Fast JavaScript image metadata parsing librarygithub.com/mattiasw/ExifReader
- 02.
- 03.Content Authenticity Initiative (CAI) — Open source provenance toolscontentauthenticity.org/
- 04.IPTC Photo Metadata Standard & Digital Source Type Vocabularyiptc.org/standards/photo-metadata/
- 05.Canvas API & ImageData — MDN Web Docsdeveloper.mozilla.org/en-US/docs/Web/API/Canvas_API
- 06.Discrete Laplace Operator in Digital Image Processing — Wikipediaen.wikipedia.org/wiki/Discrete_Laplace_operator
- 07.WebAssembly — High-performance client-side runtime standardwebassembly.org/
- 08.Google DeepMind SynthID — Imperceptible generative AI watermarkingdeepmind.google/technologies/synthid/
- 09.Stable Diffusion WebUI by AUTOMATIC1111github.com/AUTOMATIC1111/stable-diffusion-webui
- 10.ComfyUI — Powerful modular node-based Stable Diffusion GUIgithub.com/comfyanonymous/ComfyUI