A rápida expansão da inteligência artificial generativa revolucionou o ecossistema de mídia visual. Modelos de ponta como Midjourney v6, OpenAI DALL-E 3, Stable Diffusion XL, Flux.1 e Google Imagen são capazes de gerar retratos ultrarrealistas, paisagens e ilustrações em frações de segundo.
Se por um lado isso abre horizontes criativos fantásticos, por outro traz preocupações urgentes: disseminação de deepfakes, desinformação em redes sociais, poluição de bancos de imagens e dilemas sobre direitos autorais.
Para solucionar essas demandas de forma transparente, o ImageSizeFinder desenvolveu o Detector de imagens IA gratuito. Ao contrário de ferramentas pagas que cobram mensalidades por uma porcentagem opaca sem qualquer justificativa, nosso sistema adota uma arquitetura de detecção dupla com foco em privacidade, que executa checagens determinísticas direto no seu navegador e disponibiliza evidências técnicas verificáveis.
Neste guia, explicamos suas capacidades, estrutura técnica, bases matemáticas e limites de aplicação prática.
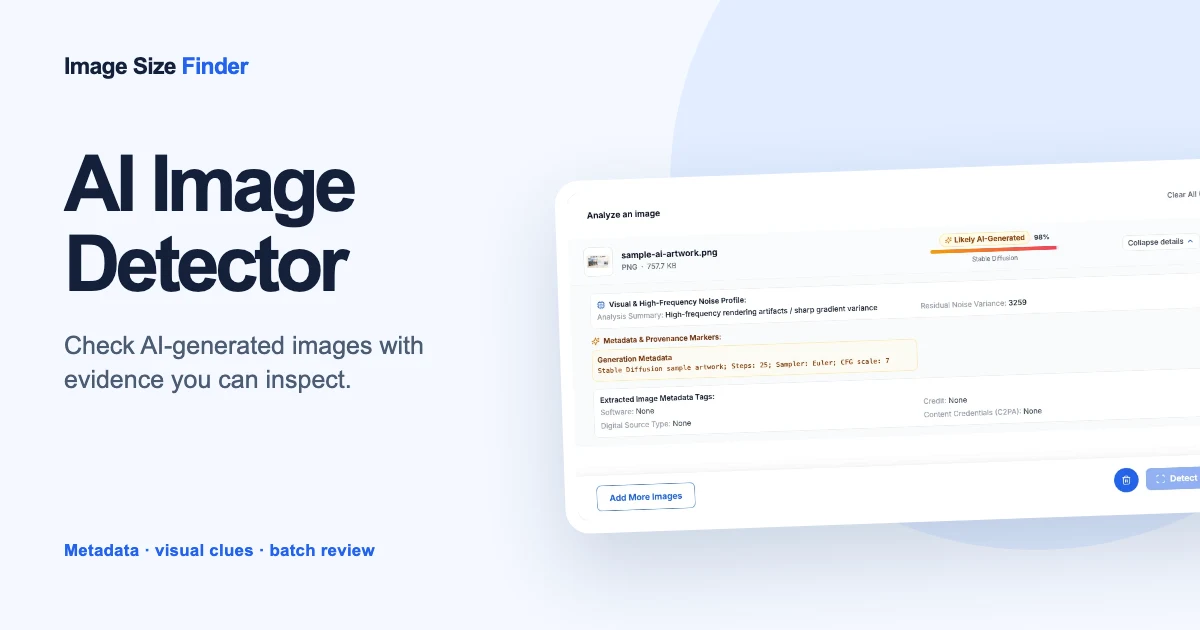 Figura 1: Interface do detector de imagens IA gratuito do ImageSizeFinder com entrada multi-origem, processamento em lote e verificação local com total privacidade.
1. Principais recursos do detector de imagens IA
O detector foi planejado para unir agilidade, confidencialidade e profundidade analítica:
- 100% gratuito e ilimitado: Sem necessidade de cadastro, sem taxas de assinatura e sem cotas diárias artificiais para exames locais no navegador.
- Privacidade total no cliente (Zero-Upload): A extração de metadados e o cálculo de ruído rodam inteiramente no seu navegador com o apoio de WebAssembly e da API HTML5 Canvas. Seus arquivos não saem do seu computador, a menos que você solicite a análise de visão em nuvem.
- Várias formas de envio:
- Arraste e solte uma ou várias fotos simultaneamente.
- Seleção clássica pelo gerenciador de arquivos do sistema.
- Colar da área de transferência: use
Ctrl+V(ouCmd+Vno macOS) em qualquer parte da tela para analisar capturas ou imagens copiadas na hora. - URL direta: informe um link
https://para verificar fotos da web sem precisar baixá-las antes.
- Painel de processamento em lote: Envie dezenas de arquivos de uma vez, acompanhe o status em uma visualização unificada e faça a varredura completa com um clique.
- Relatório de evidências detalhado: Expanda cada imagem diagnosticada para conferir exatamente o que fundamentou o resultado: marcas de software, campos IPTC, parâmetros de prompt e variância de ruído residual.
2. Arquitetura de detecção: Pipeline em duas camadas
Identificar imagens sintéticas com consistência é um grande desafio técnico, pois nenhum indicador isolado é infalível. Metadados podem ser removidos e compressões alteram as matrizes de pixels.
Por isso, implementamos uma pipeline progressiva em dois níveis:
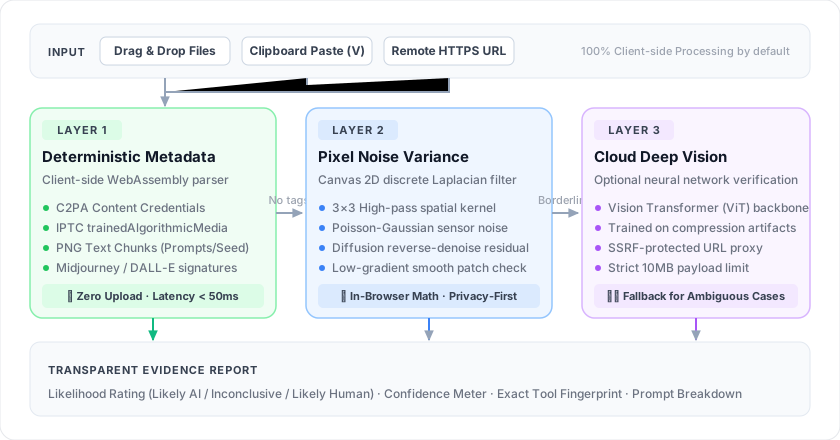 Figura 2: Arquitetura progressiva em três etapas: inspeção determinística de metadados via WebAssembly, convolução de ruído de pixels em Canvas e inferência neuronal em nuvem opcional.
3. Detalhes de implementação: Como cada camada opera
Camada 1: Metadados determinísticos e procedência
Muitas ferramentas de IA gerativa inserem parâmetros identificáveis nos arquivos ao salvá-los. A primeira camada emprega bibliotecas de alta performance no cliente (como ExifReader) para escanear a estrutura binária:
- IPTC Digital Source Type (Tipo de fonte digital):
- Padrão internacional no qual imagens geradas são rotuladas como
trainedAlgorithmicMediaoucompositeSynthetic. - Geradores como Google Imagen e Adobe Firefly gravam regularmente essa informação.
- Padrão internacional no qual imagens geradas são rotuladas como
- Campos IPTC Credit e Software:
- O Midjourney frequentemente inclui o nome
Midjourneynas tagsCreditouSoftware. - O DALL-E 3 adiciona descritores característicos da OpenAI.
- O Midjourney frequentemente inclui o nome
- Blocos de texto PNG (
tEXt,iTXt,zTXt):- Plataformas baseadas em Stable Diffusion (Automatic1111, ComfyUI, Forge) armazenam os parâmetros completos no cabeçalho PNG.
- Extraímos prompts positivos e negativos, semente (seed), escala CFG, sampler e modelos LoRA.
- Credenciais de conteúdo C2PA:
- Em conformidade com a Content Authenticity Initiative, buscamos contêineres JUMBF com manifestos criptográficos de procedência (
c2pa).
- Em conformidade com a Content Authenticity Initiative, buscamos contêineres JUMBF com manifestos criptográficos de procedência (
Ao encontrar evidências determinísticas conclusivas, o sistema classifica a imagem com alta confiança, poupando processamento subsequente.
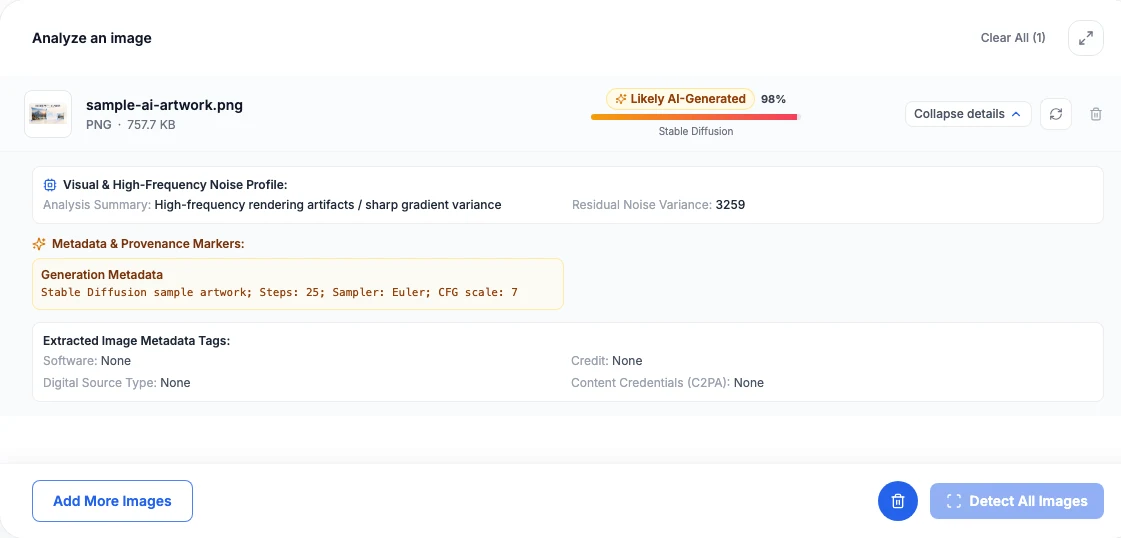 Figura 3: Detalhamento do painel de evidências exibindo os parâmetros de geração encontrados (passos, sampler, CFG) e os índices de variância de ruído.
Camada 2: Análise da variância de ruído de pixels no navegador
Quando uma imagem não traz metadados (após ser recomprimida em JPEG ou limpa por outros aplicativos), o navegador ativa a análise estatística espacial em um canvas fora da tela usando OffscreenCanvas e a API HTML5 Canvas.
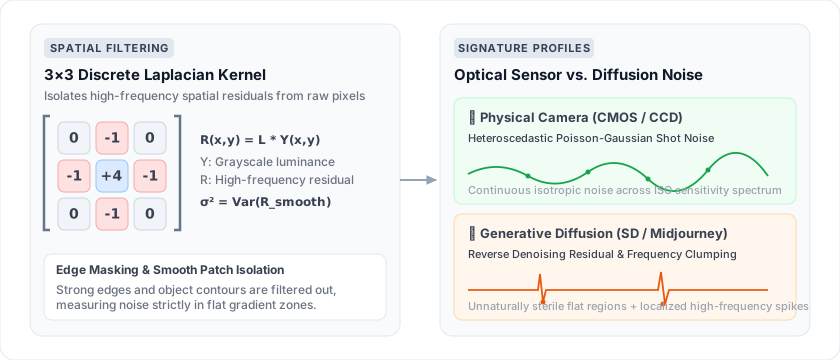 Figura 4: Convolução espacial discreta laplaciana 3x3 que isola o ruído residual de alta frequência R(x, y), comparando sensores ópticos reais com artefatos de modelos de difusão.
Fundamentos físicos e matemáticos
- Sensores de câmeras reais: Sensores fotográficos ópticos (CMOS/CCD) capturam fótons que apresentam ruído quântico de disparo e flutuações térmicas, descritos por uma distribuição Poisson-Gaussiana. Em áreas homogêneas, o grão do sensor demonstra características isotrópicas bem equilibradas.
- Modelos de difusão generativa: Ferramentas como Midjourney ou Stable Diffusion constroem imagens por remoção iterativa de ruído a partir de ruído gaussiano puro. Essa dinâmica preserva autocorrelações espaciais microscópicas: regiões lisas tornam-se artificialmente perfeitas, enquanto texturas exibem picos atípicos de alta frequência.
Passos do algoritmo
- A imagem é renderizada sem redimensionamento em um
OffscreenCanvas. - Os valores brutos de luminância
Y(x, y)são lidos viagetImageData. - Um filtro laplaciano discreto 3x3 separa os resíduos de alta frequência
R(x, y):┌ ┐ │ 0 -1 0 │ │ -1 4 -1 │ │ 0 -1 0 │ └ ┘ - As bordas nítidas são descartadas para calcular a variância residual
σ²nas áreas uniformes:σ² = (1/N) · Σ (Rᵢ − R̄)² - Os índices calculados são cruzados com uma base referencial de sensores ópticos autênticos.
Como o cálculo ocorre em JavaScript puro no seu dispositivo, ele é concluído em apenas 50 a 150 milissegundos por arquivo, com zero latência de rede.
Camada 3: Motor de visão profunda em nuvem (Opcional)
Se os metadados foram removidos e as medições de ruído caírem em uma faixa intermediária, é possível solicitar a avaliação de um modelo neural na nuvem:
- Estruturado em redes Vision Transformers treinadas com milhões de pares de imagens genuínas e sintetizadas.
- Realiza o carregamento seguro de URLs externas via
/api/ai-image-detector/fetch-url, com proteção contra ataques SSRF e limite de arquivo de 10 MB.
4. Limitações técnicas e orientações práticas
Nenhum detector de IA é 100% infalível. Para analisar os diagnósticos com equilíbrio, lembre-se das seguintes particularidades:
1. Limpeza em redes sociais e mensageiros
Plataformas como WhatsApp, Instagram ou X recomprimem arquivos e eliminam compulsoriamente todos os metadados EXIF, IPTC e C2PA. Fotos baixadas dessas redes não exibirão marcas na Camada 1, mesmo tendo sido geradas pelo Midjourney.
2. Edições intensas e compressão severa
Ajustes como desfoque gaussiano, filtros pesados de granulação de filme ou compressão JPEG agressiva (qualidade < 60) danificam as frequências finas dos pixels, podendo reduzir a precisão do laudo.
3. Arte digital e modelagem 3D
Ilustrações vetorizadas, desenhos digitais e renderizações 3D (Blender, Unreal Engine) não possuem o ruído óptico de uma lente física. Os estimadores estatísticos podem interpretar essa ausência de ruído como sinal artificial.
4. Marcas d'água latentes proprietárias (SynthID)
Marcas ocultas gravadas no espaço latente de difusão (como o SynthID do Google DeepMind) dependem de chaves e servidores privados, não podendo ser decodificadas offline em um navegador comum.
💡 Recomendação: Utilize os diagnósticos como um poderoso instrumento de apoio. Em situações delicadas, combine as evidências técnicas com o contexto em que a imagem foi publicada e com a análise de elementos visuais físicos (mãos, reflexos, coerência de iluminação).
5. Experimente agora
Deseja examinar sua primeira imagem?
- Acesse o Detector de imagens IA gratuito.
- Arraste a imagem, cole da área de transferência ou informe uma URL direta.
- Analise o percentual de probabilidade, o nível de confiança e expanda as evidências para consultar todos os dados técnicos.
Referências e leituras recomendadas
- 01.ExifReader — Fast JavaScript image metadata parsing librarygithub.com/mattiasw/ExifReader
- 02.
- 03.Content Authenticity Initiative (CAI) — Open source provenance toolscontentauthenticity.org/
- 04.IPTC Photo Metadata Standard & Digital Source Type Vocabularyiptc.org/standards/photo-metadata/
- 05.Canvas API & ImageData — MDN Web Docsdeveloper.mozilla.org/en-US/docs/Web/API/Canvas_API
- 06.Discrete Laplace Operator in Digital Image Processing — Wikipediaen.wikipedia.org/wiki/Discrete_Laplace_operator
- 07.WebAssembly — High-performance client-side runtime standardwebassembly.org/
- 08.Google DeepMind SynthID — Imperceptible generative AI watermarkingdeepmind.google/technologies/synthid/
- 09.Stable Diffusion WebUI by AUTOMATIC1111github.com/AUTOMATIC1111/stable-diffusion-webui
- 10.ComfyUI — Powerful modular node-based Stable Diffusion GUIgithub.com/comfyanonymous/ComfyUI