Стремительное развитие генеративного искусственного интеллекта кардинально изменило сферу визуального контента. Современные нейросети, такие как Midjourney v6, OpenAI DALL-E 3, Stable Diffusion XL, Flux.1 и Google Imagen, способны за секунды синтезировать реалистичные портреты, пейзажи и фотоснимки.
Наряду с колоссальными творческими возможностями это породило серьезные риски: распространение фейковых новостей, дипфейков, засорение фотобанков и споры об авторском праве.
Чтобы решить эту задачу открыто и надежно, команда ImageSizeFinder создала Бесплатный детектор изображений ИИ. В отличие от коммерческих платформ, требующих платную подписку за ничем не подкрепленный процент, наш инструмент опирается на конфиденциальную двухуровневую архитектуру. Анализ выполняется прямо в вашем браузере с предоставлением прозрачных и проверяемых технических доказательств.
В этом руководстве мы подробно разбираем функционал, архитектуру, математические принципы и практические ограничения детектора.
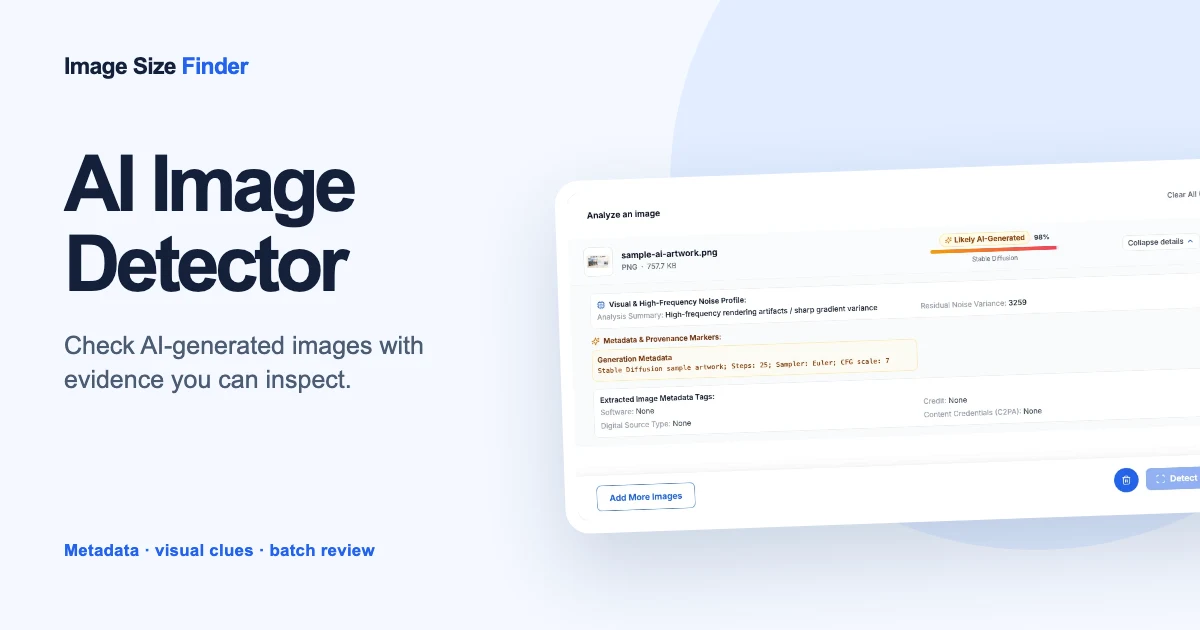 Рисунок 1: Интерфейс бесплатного детектора изображений ИИ ImageSizeFinder с поддержкой множественных источников, пакетной обработки и локальной проверки с защитой приватности.
1. Ключевые возможности детектора изображений ИИ
Инструмент спроектирован так, чтобы совместить высокую скорость, надежную защиту данных и аналитическую глубину:
- 100% бесплатно и без ограничений: Никаких регистраций, платных подписок и искусственных лимитов на количество локальных проверок в браузере.
- Полная конфиденциальность (Zero-Upload): Парсинг метаданных и расчет остаточного шума пикселей выполняются на вашем устройстве через WebAssembly и HTML5 Canvas API. Ваши файлы не отправляются на удаленный сервер, если вы сами не запросите облачную нейросетевую проверку.
- Удобные способы загрузки файлов:
- Перетаскивание одного или группы изображений (Drag and Drop).
- Выбор файлов через системный файловый менеджер.
- Вставка из буфера обмена: нажмите
Ctrl+V(илиCmd+Vна macOS) в любом месте страницы, чтобы мгновенно проверить скриншот. - Прямой URL изображения: вставьте ссылку
https://для проверки файлов из сети без их предварительного скачивания.
- Пакетная обработка изображений: Загружайте десятки картинок за раз, отслеживайте их статус в общем списке и запускайте сканирование в один клик.
- Прозрачная панель доказательств: Разверните карточку любого изображения, чтобы увидеть точные технические аргументы: метки генератора, теги IPTC, параметры промпта и дисперсию шума.
2. Архитектура анализа: Двухуровневый конвейер
Надежное распознавание синтетических изображений — непростая задача, так как ни один признак не дает стопроцентной гарантии. Метаданные можно удалить, а сжатие искажает структуру пикселей.
Наша система использует поэтапный двухуровневый конвейер:
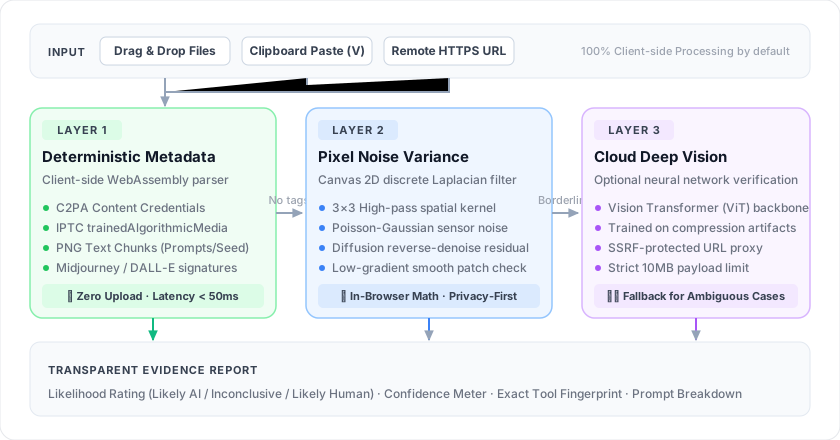 Рисунок 2: Трехуровневая прогрессивная архитектура: быстрый поиск детерминированных метаданных в WebAssembly, расчет высокочастотного шума в Canvas и опциональная нейросетевая верификация в облаке.
3. Технические детали: Принцип работы каждого уровня
Уровень 1: Детерминированные метаданные и цифровой след
Многие нейросетевые редакторы при сохранении внедряют машиночитаемые идентификаторы. Первый уровень использует клиентские бинарные библиотеки (такие как ExifReader) для сканирования структуры файла:
- IPTC Digital Source Type (Тип цифрового источника):
- Международный стандарт, в котором генерации отмечаются как
trainedAlgorithmicMediaилиcompositeSynthetic. - Сервисы Google Imagen и Adobe Firefly стабильно заполняют этот атрибут.
- Международный стандарт, в котором генерации отмечаются как
- Теги IPTC Credit и Software:
- Midjourney часто записывает слово
Midjourneyв графуCreditилиSoftware. - DALL-E 3 содержит фирменные маркеры от OpenAI.
- Midjourney часто записывает слово
- Текстовые блоки формата PNG (
tEXt,iTXt,zTXt):- ПО экосистемы Stable Diffusion (Automatic1111, ComfyUI, Forge) сохраняет все настройки генерации в заголовке PNG.
- Мы извлекаем положительный и отрицательный промпты, сид (seed), шкалу CFG, алгоритм сэмплера и имена моделей LoRA.
- Сертификаты происхождения C2PA:
- В соответствии со спецификацией Content Authenticity Initiative детектор ищет блоки JUMBF с цифровыми подписями подлинности (
c2pa).
- В соответствии со спецификацией Content Authenticity Initiative детектор ищет блоки JUMBF с цифровыми подписями подлинности (
При обнаружении однозначных детерминированных метаданных алгоритм присваивает вердикт Высокая уверенность (High Confidence) без лишней нагрузки на процессор.
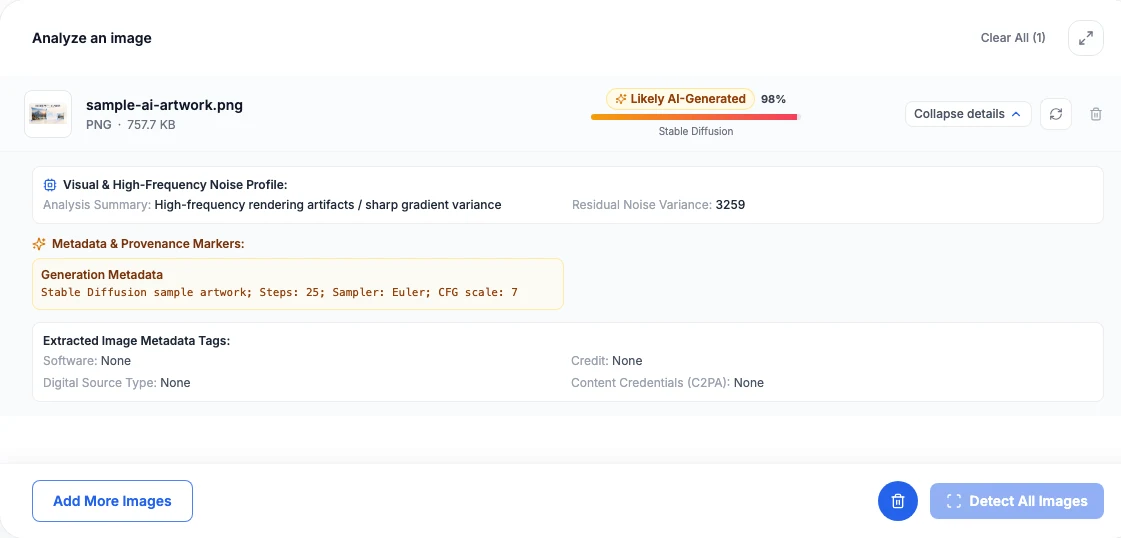 Рисунок 3: Раскрытая панель доказательств с найденными параметрами генерации (шаги, сэмплер, CFG) и метриками дисперсии шума пикселей.
Уровень 2: Анализ дисперсии высокочастотного шума в браузере
Если метаданные отсутствуют (например, после пересохранения в JPEG или очистки программами), браузер выполняет пространственный статистический анализ на невидимом холсте через OffscreenCanvas и HTML5 Canvas API.
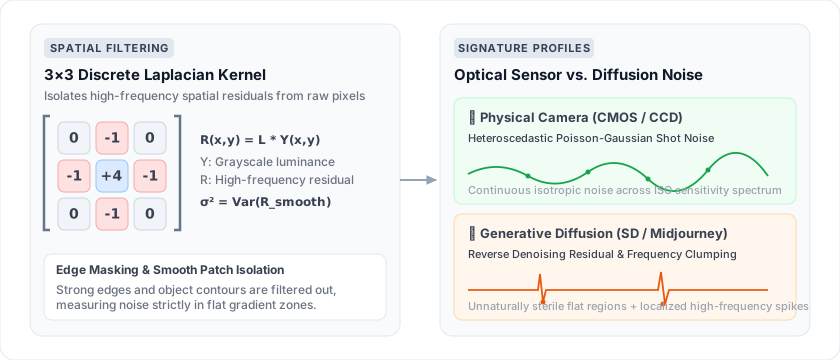 Рисунок 4: Дискретная пространственная свертка Лапласа 3x3, выделяющая остаточный шум R(x, y), и сравнение оптического сенсора с диффузионными моделями.
Физические и математические основы
- Физические сенсоры фотокамер: Оптические матрицы (CMOS/CCD) улавливают кванты света, подверженные дробовому шуму фотонов и тепловым флуктуациям. Они подчиняются распределению Пуассона-Гаусса. На однородных поверхностях шум сенсора имеет естественную изотропную структуру.
- Диффузионные генеративные модели: Модели вроде Stable Diffusion или Midjourney строят изображение путем последовательного удаления шума из начального гауссова поля. Этот алгоритм оставляет характерные микроструктурные автокорреляции: гладкие поверхности выглядят чересчур «стерильными», а текстуры содержат аномальные высокочастотные всплески.
Этапы работы алгоритма
- Отрисовка изображения в оригинальном масштабе на
OffscreenCanvas. - Извлечение яркостной матрицы
Y(x, y)через вызовgetImageData. - Применение дискретного 3x3 ядра свертки Лапласа для изоляции остаточного высокочастотного шума
R(x, y):┌ ┐ │ 0 -1 0 │ │ -1 4 -1 │ │ 0 -1 0 │ └ ┘ - Отсечение контрастных контуров и расчет остаточной дисперсии
σ²на монотонных участках:σ² = (1/N) · Σ (Rᵢ − R̄)² - Сравнение полученной дисперсии с эталонными характеристиками сенсоров настоящих камер.
Поскольку математические расчеты выполняет JavaScript на вашем компьютере, проверка занимает всего 50–150 миллисекунд на файл без сетевых задержек.
Уровень 3: Облачная модель компьютерного зрения (Опционально)
Если метаданные стерты, а параметры шума находятся в пограничной зоне неопределенности, пользователь может задействовать глубокую нейросеть в облаке:
- Построена на базе архитектуры Vision Transformer, обученной на миллионах реальных и синтетических изображений.
- Безопасная обработка внешних ссылок (
/api/ai-image-detector/fetch-url) с защитой от SSRF-атак и ограничением размера файла в 10 МБ.
4. Ограничения технологии и практические советы
Ни один детектор ИИ не гарантирует 100% точности. При анализе результатов важно учитывать следующие обстоятельства:
1. Очистка метаданных социальными сетями
Мессенджеры и соцсети (Telegram, WhatsApp, Instagram, X) при отправке сжимают файлы и полностью стирают метаданные EXIF, IPTC и C2PA. Скачанные из соцсетей файлы не покажут результатов на Уровне 1.
2. Вторичная обработка и агрессивное сжатие
Применение размытия, наложение фильтров пленочного зерна или сильное JPEG-сжатие (качество < 60) нарушают тонкий шумовой рисунок пикселей, снижая уверенность детектора.
3. Цифровые рисунки и 3D-графика
Иллюстрации, векторная графика и 3D-рендеры (Blender, Unreal Engine) изначально лишены шума оптического сенсора. Программа может счесть эту гладкость признаком ИИ. Обязательно учитывайте жанр изображения.
4. Закрытые латентные водяные знаки (SynthID)
Невидимые цифровые подписи, встроенные глубоко в латентное пространство моделей (такие как SynthID от Google DeepMind), требуют закрытых серверных ключей и не могут быть расшифрованы локально в браузере.
💡 Совет: Воспринимайте отчет детектора как объективное аналитическое подспорье. При анализе резонансных материалов всегда сопоставляйте данные детектора с источником публикации и визуальной логикой физического мира (анатомия рук, блики, тени).
5. Проверьте изображение прямо сейчас
Готовы протестировать детектор в деле?
- Откройте Бесплатный детектор изображений ИИ.
- Перетащите файл, вставьте картинку из буфера обмена или укажите URL.
- Ознакомьтесь с оценкой вероятности и разверните блок доказательств, чтобы изучить подробные технические параметры.
Источники и дополнительная литература
- 01.ExifReader — Fast JavaScript image metadata parsing librarygithub.com/mattiasw/ExifReader
- 02.
- 03.Content Authenticity Initiative (CAI) — Open source provenance toolscontentauthenticity.org/
- 04.IPTC Photo Metadata Standard & Digital Source Type Vocabularyiptc.org/standards/photo-metadata/
- 05.Canvas API & ImageData — MDN Web Docsdeveloper.mozilla.org/en-US/docs/Web/API/Canvas_API
- 06.Discrete Laplace Operator in Digital Image Processing — Wikipediaen.wikipedia.org/wiki/Discrete_Laplace_operator
- 07.WebAssembly — High-performance client-side runtime standardwebassembly.org/
- 08.Google DeepMind SynthID — Imperceptible generative AI watermarkingdeepmind.google/technologies/synthid/
- 09.Stable Diffusion WebUI by AUTOMATIC1111github.com/AUTOMATIC1111/stable-diffusion-webui
- 10.ComfyUI — Powerful modular node-based Stable Diffusion GUIgithub.com/comfyanonymous/ComfyUI