ความก้าวหน้าอย่างก้าวกระโดดของปัญญาประดิษฐ์เชิงสร้างสรรค์ (Generative AI) ได้เปลี่ยนโฉมวงการสื่อภาพไปอย่างสิ้นเชิง โมเดลชั้นนำอย่าง Midjourney v6, OpenAI DALL-E 3, Stable Diffusion XL, Flux.1 และ Google Imagen สามารถสร้างภาพถ่ายบุคคล ทิวทัศน์ และภาพประกอบที่สมจริงจนยากจะแยกออกได้ด้วยตาเปล่าในเวลาเพียงไม่กี่วินาที
แม้สิ่งนี้จะช่วยจุดประกายความคิดสร้างสรรค์อย่างไร้ขีดจำกัด แต่ก็นำมาซึ่งปัญหาท้าทายมากมาย เช่น การแพร่กระจายของข่าวปลอม ดีพเฟก (Deepfake) การปนเปื้อนในคลังภาพสต็อก และข้อพิพาทด้านลิขสิทธิ์
เพื่อรับมือกับความท้าทายนี้อย่างโปร่งใส ImageSizeFinder จึงได้พัฒนา เครื่องตรวจจับภาพ AI ฟรี แตกต่างจากเครื่องมือทั่วไปที่เรียกเก็บค่าบริการรายเดือนและให้คะแนนเปอร์เซ็นต์โดยไม่มีเหตุผลอธิบาย เครื่องมือของเราทำงานบน สถาปัตยกรรมการตรวจจับแบบสองชั้นที่เน้นความเป็นส่วนตัวเป็นอันดับแรก โดยประมวลผลการคำนวณภายในเว็บเบราว์เซอร์ของคุณโดยตรง และเปิดเผยหลักฐานทางเทคนิคที่ตรวจสอบได้อย่างชัดเจน
ในบทความนี้ เราจะอธิบายคุณสมบัติหลัก สถาปัตยกรรมระบบ หลักการทางคณิตศาสตร์ และข้อจำกัดในการใช้งานจริง
 ภาพที่ 1: หน้าต่างการทำงานของเครื่องตรวจจับภาพ AI ฟรี ImageSizeFinder รองรับการนำเข้าหลายช่องทาง การประมวลผลแบบกลุ่ม และการตรวจจับแบบเป็นส่วนตัวในเครื่อง
1. ฟังก์ชันเด่นของเครื่องตรวจจับภาพ AI
เครื่องมือนี้ได้รับการออกแบบมาเพื่อให้ตอบโจทย์ทั้งความเร็ว ความเป็นส่วนตัว และความแม่นยำในการวิเคราะห์:
- ใช้งานฟรี 100% และไม่จำกัดจำนวนครั้ง: ไม่ต้องลงทะเบียนบัญชี ไม่คิดค่าธรรมเนียม และไม่มีการจำกัดโควตาการสแกนในเบราว์เซอร์ประจำวัน
- ความปลอดภัยและความเป็นส่วนตัวในเครื่อง (Zero-Upload): การอ่านข้อมูลเมตาและการคำนวณสัญญาณรบกวนพิกเซลทำงานบนเบราว์เซอร์ของคุณทั้งหมดผ่าน WebAssembly และ HTML5 Canvas API ภาพจะไม่ถูกอัปโหลดไปยังเซิร์ฟเวอร์ภายนอกเว้นแต่คุณจะเลือกใช้การวิเคราะห์เชิงลึกบนคลาวด์
- ช่องทางการใส่ภาพที่หลากหลาย:
- ลากและวางไฟล์ภาพเดี่ยวหรือหลายไฟล์พร้อมกัน
- เลือกไฟล์ผ่านหน้าต่างจัดการไฟล์ของระบบ
- วางจากคลิปบอร์ด: กด
Ctrl+V(หรือCmd+Vบน macOS) ที่ตำแหน่งใดก็ได้บนหน้าเว็บเพื่อตรวจภาพถ่ายหน้าจอได้ทันที - ลิงก์ URL ภาพโดยตรง: วางลิงก์
https://เพื่อตรวจภาพออนไลน์โดยไม่ต้องดาวน์โหลดลงเครื่องก่อน
- พื้นที่ทำงานประมวลผลแบบกลุ่ม: จัดการภาพหลายสิบภาพพร้อมกัน ติดตามสถานะได้อย่างเป็นระบบ และสั่งวิเคราะห์ทั้งหมดได้ในคลิกเดียว
- แผงแสดงหลักฐานอย่างโปร่งใส: คลิกขยายดูรายละเอียดของภาพแต่ละภาพเพื่อดูเหตุผลเบื้องหลังการประเมิน เช่น ร่องรอยซอฟต์แวร์ แท็ก IPTC พารามิเตอร์พรอมต์ และค่าความแปรปรวนของสัญญาณรบกวนพิกเซล
2. สถาปัตยกรรมการตรวจจับ: กระบวนการสองชั้นแบบต่อเนื่อง
การระบุภาพที่สร้างด้วย AI อย่างแม่นยำเป็นเรื่องซับซ้อน เพราะไม่มีตัวบ่งชี้ใดที่สมบูรณ์แบบเพียงลำพัง ข้อมูลเมตาอาจถูกลบออกได้ และการบีบอัดซ้ำก็ทำให้โครงสร้างพิกเซลผิดเพี้ยนไป
ระบบของเราจึงใช้ สถาปัตยกรรมสองชั้นแบบเป็นลำดับขั้น:
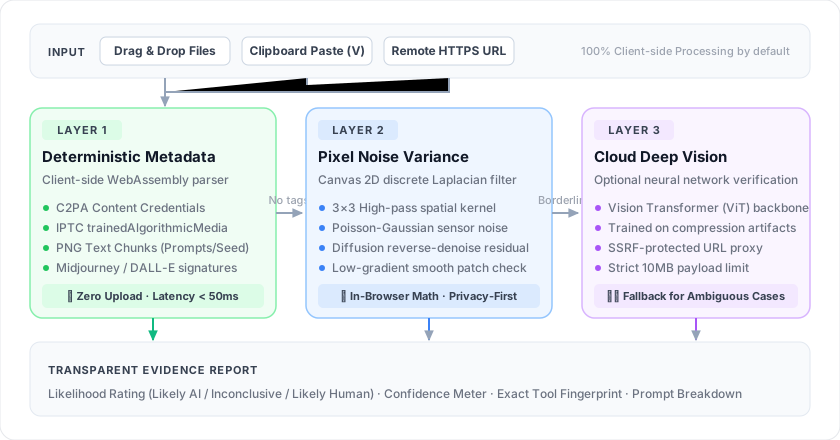 ภาพที่ 2: สถาปัตยกรรมสามระดับ: การตรวจสอบข้อมูลเมตาอย่างรวดเร็วด้วย WebAssembly, การคำนวณสัญญาณรบกวนพิกเซลบน Canvas และการวิเคราะห์เสริมด้วยโมเดลวิทัศน์บนคลาวด์
3. รายละเอียดเชิงเทคนิค: การทำงานของแต่ละชั้น
ชั้นที่ 1: การตรวจสอบข้อมูลเมตาและแหล่งกำเนิด
เครื่องมือสร้างภาพ AI จำนวนมากจะบันทึกรหัสเฉพาะตามมาตรฐานอุตสาหกรรม ชั้นแรกจะใช้ไลบรารีวิเคราะห์ข้อมูลไบนารีในเบราว์เซอร์ (เช่น ExifReader) เพื่อสแกนโครงสร้างของไฟล์:
- IPTC Digital Source Type (ประเภทแหล่งที่มาดิจิทัล):
- มาตรฐานข้อมูลภาพระดับสากล ภาพที่สร้างด้วย AI มักถูกระบุเป็น
trainedAlgorithmicMediaหรือcompositeSynthetic - เครื่องมืออย่าง Google Imagen และ Adobe Firefly จะบันทึกข้อมูลฟิลด์นี้เสมอ
- มาตรฐานข้อมูลภาพระดับสากล ภาพที่สร้างด้วย AI มักถูกระบุเป็น
- แท็ก IPTC Credit และ Software:
- Midjourney มักจะระบุคำว่า
Midjourneyลงในฟิลด์CreditหรือSoftware - DALL-E 3 จะมีป้ายกำกับเฉพาะที่ระบุว่าเป็นผลงานของ OpenAI
- Midjourney มักจะระบุคำว่า
- บล็อกข้อความในไฟล์ PNG (
tEXt,iTXt,zTXt):- โปรแกรมสาย Stable Diffusion (Automatic1111, ComfyUI, Forge) มักเก็บการตั้งค่าการสร้างภาพทั้งหมดไว้ในส่วนหัวของ PNG
- เราสามารถดึงข้อความพรอมต์คำสั่ง คำสั่งเชิงลบ ค่า Seed ค่า CFG Scale ชนิด Sampler และโมเดล LoRA ได้อย่างครบถ้วน
- ข้อมูลรับรอง C2PA:
- ตามข้อกำหนดของ Content Authenticity Initiative ระบบจะค้นหากล่อง JUMBF ที่มีลายเซ็นดิจิทัลรับรองที่มาของภาพ (
c2pa)
- ตามข้อกำหนดของ Content Authenticity Initiative ระบบจะค้นหากล่อง JUMBF ที่มีลายเซ็นดิจิทัลรับรองที่มาของภาพ (
หากพบหลักฐานยืนยันที่แน่ชัดในส่วนนี้ ระบบจะระบุผลลัพธ์ด้วย ความเชื่อมั่นสูง (High Confidence) ทันทีโดยไม่ต้องประมวลผลขั้นสูงต่อไป
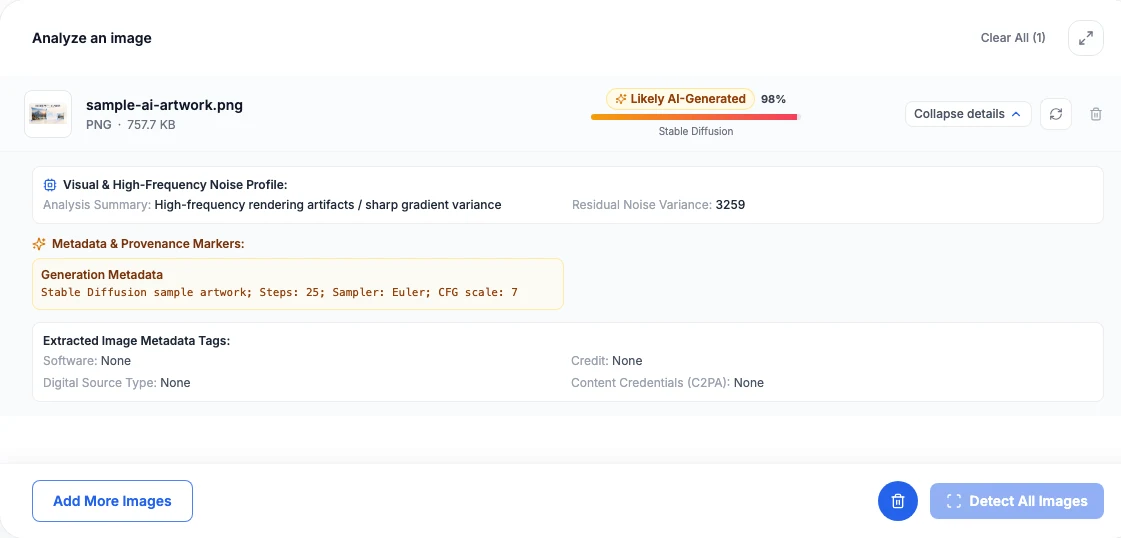 ภาพที่ 3: แผงแสดงหลักฐานเชิงลึก แสดงพารามิเตอร์การสร้างภาพที่ตรวจพบ (ขั้นตอน, Sampler, CFG) ควบคู่กับค่าสัญญาณรบกวนพิกเซล
ชั้นที่ 2: การวิเคราะห์ความแปรปรวนของสัญญาณรบกวนพิกเซลในเบราว์เซอร์
ในกรณีที่ภาพไม่มีข้อมูลเมตา (เช่น ถูกแปลงเป็น JPEG หรือถูกลบข้อมูลออก) เบราว์เซอร์จะทำการวิเคราะห์ทางสถิติในพื้นที่ว่างหลังฉากด้วย OffscreenCanvas และ HTML5 Canvas API
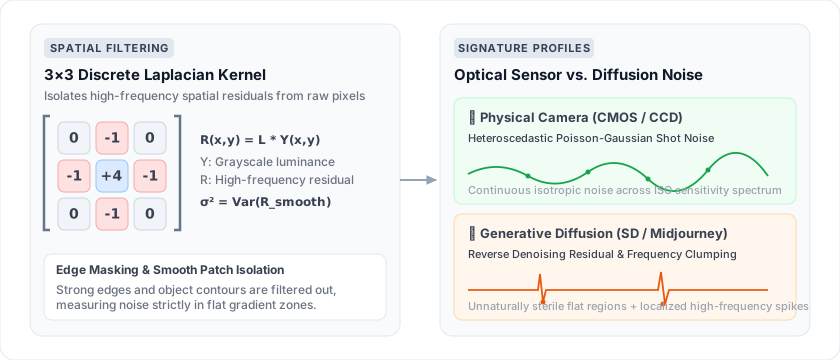 ภาพที่ 4: การกรองแบบคอนโวลูชัน Laplacian 3x3 เพื่อแยกสัญญาณรบกวนตกค้างความถี่สูง R(x, y) เปรียบเทียบระหว่างเซนเซอร์กล้องจริงกับกระบวนการดีนอยส์ของ AI
หลักการทางฟิสิกส์และคณิตศาสตร์
- เซนเซอร์กล้องถ่ายภาพจริง: เซนเซอร์ออปติคัล (CMOS/CCD) จะจับอนุภาคโฟตอนซึ่งมาพร้อมสัญญาณรบกวนควอนตัม (Shot Noise) และความผันผวนจากความร้อนตามการแจกแจงทางสถิติแบบ Poisson-Gaussian บนพื้นผิวที่เรียบสม่ำเสมอ สัญญาณรบกวนของเซนเซอร์จะมีลักษณะการกระจายตัวอย่างเป็นธรรมชาติ
- โมเดลการแพร่กระจายของ AI (Diffusion Models): โมเดลอย่าง Stable Diffusion หรือ Midjourney สร้างภาพจากการทยอยลดสัญญาณรบกวนแบบเกาส์เซียน กระบวนการนี้จะทิ้งร่องรอยความสัมพันธ์เชิงพื้นที่ความถี่สูงเอาไว้ บริเวณที่เรียบเนียนมักจะดูราบเรียบเกินจริง ส่วนบริเวณที่มีลวดลายก็มักมีการกระจุกตัวของความถี่สูงอย่างผิดปกติ
ขั้นตอนของอัลกอริทึม
- วาดภาพลงบน
OffscreenCanvasตามขนาดจริง - ดึงค่าความสว่างขาวดำ
Y(x, y)ออกมาด้วยคำสั่งgetImageData - ใช้ตัวกรองคอนโวลูชัน Laplacian ขนาด 3x3 เพื่อแยกสัญญาณรบกวนตกค้างความถี่สูง
R(x, y):┌ ┐ │ 0 -1 0 │ │ -1 4 -1 │ │ 0 -1 0 │ └ ┘ - ตัดขอบที่มีความเปรียบต่างสูงออก แล้วคำนวณค่าความแปรปรวนตกค้าง
σ²ในบริเวณที่เรียบเนียน:σ² = (1/N) · Σ (Rᵢ − R̄)² - นำค่าที่ได้ไปเปรียบเทียบกับฐานข้อมูลอ้างอิงของเซนเซอร์กล้องจริง
เนื่องจากการประมวลผลทั้งหมดทำงานผ่านโค้ด JavaScript บนเครื่องของคุณ จึงใช้เวลาเพียง 50–150 มิลลิวินาทีต่อภาพ และไม่มีความล่าช้าจากเครือข่าย
ชั้นที่ 3: ระบบวิทัศน์เชิงลึกบนคลาวด์ (ตัวเลือกเสริม)
หากข้อมูลเมตาขาดหายไปและค่าสัญญาณรบกวนอยู่ในระดับที่ก้ำกึ่ง ผู้ใช้สามารถเลือกใช้งานโมเดลวิทัศน์บนคลาวด์ได้:
- พัฒนาด้วยโครงข่าย Vision Transformer ที่ผ่านการฝึกฝนจากภาพถ่ายจริงและภาพจำลองจำนวนมหาศาล
- รองรับการวิเคราะห์ภาพผ่าน URL จากภายนอก พร้อมระบบป้องกันการโจมตี SSRF และการจำกัดขนาดไฟล์ไม่เกิน 10 MB
4. ข้อจำกัดและสิ่งที่ควรทราบ
ไม่มีเครื่องมือตรวจจับ AI ใดในโลกที่มีความถูกต้อง 100% โปรดคำนึงถึงปัจจัยเหล่านี้เมื่อประเมินผล:
1. การลบข้อมูลของโซเชียลมีเดีย
แพลตฟอร์มอย่าง LINE, Facebook, Instagram หรือ Twitter/X จะบีบอัดภาพและ ลบข้อมูลเมตา EXIF, IPTC และ C2PA ทั้งหมดออกโดยอัตโนมัติ ภาพที่ดาวน์โหลดมาจากแพลตฟอร์มเหล่านี้จึงไม่สามารถตรวจพบข้อมูลในชั้นที่ 1 ได้
2. การตกแต่งภาพและการบีบอัดคุณภาพต่ำ
การใส่ฟิลเตอร์เบลอ การเพิ่มเกรนฟิล์ม หรือการบีบอัด JPEG คุณภาพต่ำมาก (Quality < 60) จะทำลายโครงสร้างสัญญาณรบกวนในระดับพิกเซล ซึ่งอาจส่งผลต่อความแม่นยำในการวิเคราะห์
3. ภาพวาดดิจิทัลและงานเรนเดอร์ 3D
ภาพวาดลายเส้นหรือภาพเรนเดอร์ 3 มิติ (Blender, Unreal Engine) ย่อมไม่มีสัญญาณรบกวนจากเซนเซอร์กล้องจริง อัลกอริทึมอาจมองความเรียบเนียนนี้ว่าเป็นภาพที่สร้างขึ้น โปรดพิจารณาบริบทของผลงานเสมอ
4. ลายน้ำแฝงระดับลึก (เช่น SynthID)
ลายน้ำที่ฝังลึกลงในโครงสร้างเวกเตอร์แฝง (เช่น SynthID ของ Google DeepMind) จำเป็นต้องใช้คีย์ถอดรหัสเฉพาะของเซิร์ฟเวอร์เจ้าของเทคโนโลยี ไม่สามารถตรวจสอบแบบออฟไลน์ในเบราว์เซอร์ทั่วไปได้
💡 คำแนะนำ: ขอแนะนำให้ใช้ผลการตรวจจับเป็นข้อมูลประกอบการพิจารณา สำหรับเนื้อหาสำคัญ ควรตรวจสอบร่วมกับบริบทการเผยแพร่ และความสมเหตุสมผลทางกายภาพของภาพ (เช่น ลักษณะนิ้วมือ แสงเงา และการสะท้อน)
5. เริ่มต้นใช้งานได้ทันที
พร้อมทดสอบภาพของคุณแล้วหรือยัง?
- เข้าไปที่ เครื่องตรวจจับภาพ AI ฟรี
- ลากภาพมาวาง วางจากคลิปบอร์ด หรือกรอก URL ของภาพ
- ตรวจสอบคะแนนความน่าจะเป็น ระดับความเชื่อมั่น และขยายแผงหลักฐานเพื่อดูข้อมูลเมตาและสัญญาณรบกวนพิกเซล
เอกสารอ้างอิงและการศึกษาเพิ่มเติม
- 01.ExifReader — Fast JavaScript image metadata parsing librarygithub.com/mattiasw/ExifReader
- 02.
- 03.Content Authenticity Initiative (CAI) — Open source provenance toolscontentauthenticity.org/
- 04.IPTC Photo Metadata Standard & Digital Source Type Vocabularyiptc.org/standards/photo-metadata/
- 05.Canvas API & ImageData — MDN Web Docsdeveloper.mozilla.org/en-US/docs/Web/API/Canvas_API
- 06.Discrete Laplace Operator in Digital Image Processing — Wikipediaen.wikipedia.org/wiki/Discrete_Laplace_operator
- 07.WebAssembly — High-performance client-side runtime standardwebassembly.org/
- 08.Google DeepMind SynthID — Imperceptible generative AI watermarkingdeepmind.google/technologies/synthid/
- 09.Stable Diffusion WebUI by AUTOMATIC1111github.com/AUTOMATIC1111/stable-diffusion-webui
- 10.ComfyUI — Powerful modular node-based Stable Diffusion GUIgithub.com/comfyanonymous/ComfyUI