随着 Midjourney v6、OpenAI DALL-E 3、Stable Diffusion XL、Flux.1 以及各类商用生成式 AI 技术的飞速迭代,AI 生成图片的逼真程度已经达到肉眼难以分辨的地步。从人像摄影、新闻纪实到风景插画,合成媒体在带来无限创作便利的同时,也带来了虚假信息传播、版权归属纠纷、摄影竞赛造假等诸多现实挑战。
目前市面上的 AI 检测工具往往存在**费用高昂、必须上传原图存在隐私泄露风险、检测机制犹如黑盒(仅给出一个毫无根据的百分比)**等痛点。
为此,ImageSizeFinder 推出了全新的 免费 AI 图片检测器。它采用隐私优先、浏览器本地为主的双层检测架构,不仅检测速度快、完全免费,而且会详细展开检测到的元数据标记、算法证据与置信度,让用户清晰看到结论背后的依据。
本文将深入介绍该检测器的核心功能特性、架构实现原理、算法细节以及实际应用中的边界与注意事项。
 图 1:ImageSizeFinder 免费 AI 图片检测器全景界面,提供多源载入、批量管理与端侧透明证据链。
一、核心功能特性概览
为了兼顾普通用户的使用便捷度与专业创作者对隐私和深度的要求,检测器设计了以下特性:
- 完全免费且无使用上限: 无需注册登录、无需绑定信用卡、没有人工设置的每日扫描额度,浏览器本地检测完全开放。
- 端侧隐私保护(Zero-Upload): 核心元数据解析与高频噪点数学分析完全通过浏览器端的 WebAssembly 与 HTML5 Canvas API 在您的设备上完成,图片无需上传至远程服务器。
- 多渠道便捷输入方式:
- 多图拖拽:单张或一次选中几十张图片拖入区域;
- 本地选择:点击按钮调用系统文件管理器;
- 剪贴板直接粘贴:在页面任意位置直接按下
Ctrl+V(Mac 为Cmd+V)即可快速将复制的图片或截图载入分析; - 图片 URL 直链:粘贴外部
https://直链,直接通过安全代理拉取检测,省去先下载再上传的繁琐操作。
- 统一批量处理工作区: 支持批量管理多张图片,列表清晰展示检测进度、缩略图、评分结果,并提供「一键全部检测」和批量清除操作。
- 透明证据链与参数溯源: 展开任意已检测图片,可直观查看生成工具标识(如 Midjourney、DALL-E 3)、IPTC 来源标记、Stable Diffusion 原始提示词与生成参数、以及像素残差噪点方差。
二、系统检测架构:双层渐进式工作流
由于单项指标很容易被二次转码或人为处理抹去,单一维度的检测工具极易失效。为此,我们设计了渐进式多维度检测架构:
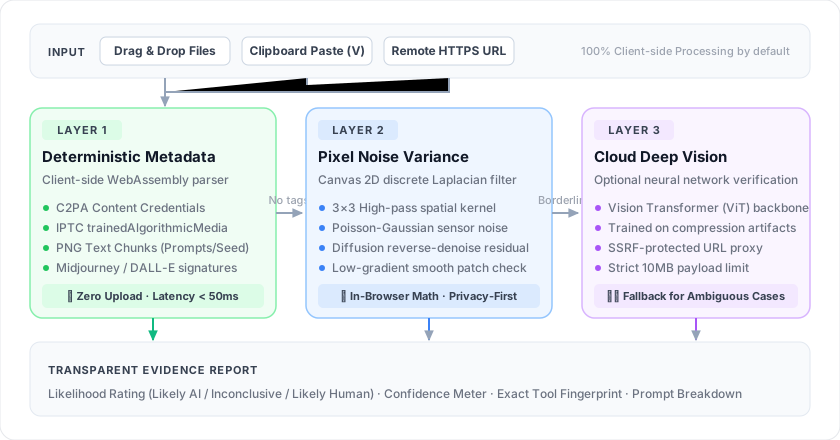 图 2:三层渐进式流水线架构:端侧 WebAssembly 确定性元数据快速筛查、Canvas 像素高频残差噪点卷积运算与云端辅助推理。
三、底层实现原理与算法细节
1. 第一层:确定性元数据与版权溯源解析
许多主流 AI 生成工具在导出图片时,都会遵循行业标准或软件规范写入机器可读标识。第一层利用浏览器端高性能元数据解析库(ExifReader)对二进制数据流进行快速扫描:
- IPTC Digital Source Type(数字来源类型):
行业国际标准,AI 生成图片常标记为
trainedAlgorithmicMedia(算法模型训练生成)或compositeSynthetic(合成媒体)。Google Imagen、Adobe Firefly 等均会写入此字段。 - IPTC Credit 与 Software(版权与软件标识):
Midjourney Web 导出版本通常会在
Credit或Software字段直接写入Midjourney字样;DALL-E 3 同样具备专门的厂商描述信息。 - PNG 文本块(tEXt / iTXt / zTXt):
Stable Diffusion 生态(Automatic1111 WebUI、ComfyUI、SD.Next 等)默认会在 PNG 的文字块中写入完整的生成信息。我们通过底层二进制扫描,可直接提取出:
- 正向提示词(Prompt)与负向提示词(Negative Prompt)
- 采样步数(Steps)、采样器(Sampler)
- 随机种子(Seed)、CFG Scale
- 基础模型与 LoRA 权重名称
- C2PA 内容凭据(Content Credentials):
针对数字内容安全联盟规范(Content Authenticity Initiative),扫描文件中是否包含以 JUMBF(JPEG Universal Metadata Box Format)格式封装的数字水印签名容器(
c2pabox 标识)。
若本层检测到了确凿证据,系统会直接判定为 高置信度,无需消耗后续算力。
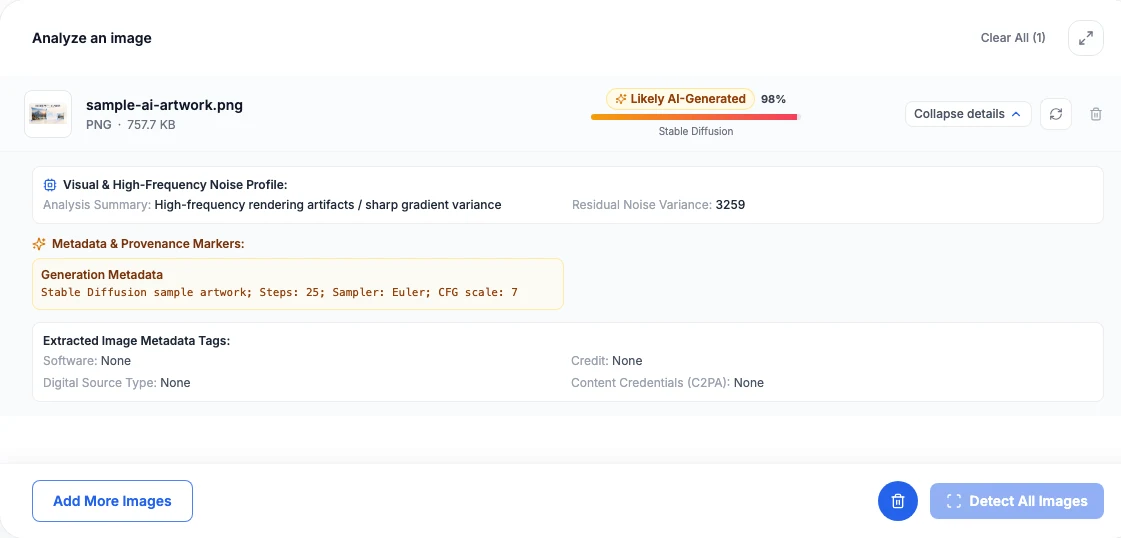 图 3:证据详情面板展开:完整呈现检测出的 Stable Diffusion 模型生成提示词、采样步数、CFG Scale 及残差噪点方差等透明线索。
2. 第二层:端侧像素高频噪点方差分析(Pixel Noise Analysis)
当图片被另存为 JPEG 或由第三方工具洗掉元数据后,系统将进入像素级统计分析阶段,借助浏览器 OffscreenCanvas 与 HTML5 Canvas API 进行实时图像空间滤波分析。
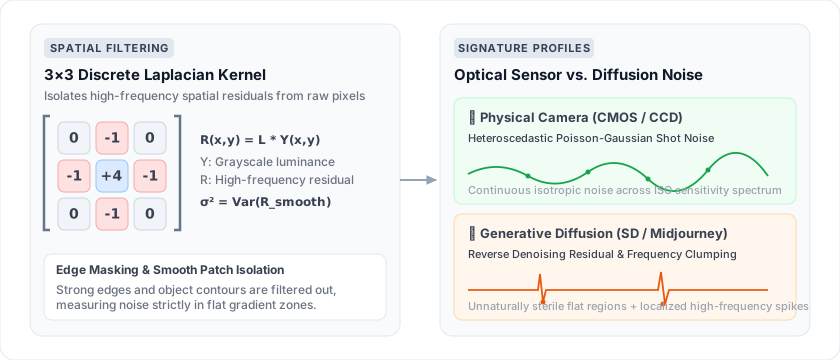 图 4:3x3 离散拉普拉斯空间高通卷积核与平滑区方差计算,有效对比物理光学传感器散粒噪声与扩散模型反向去噪残差。
物理与数学原理
- 真实摄影设备:真实相机镜头与光学传感器(CMOS/CCD)在捕获光子时,受到光子散粒噪声与传感器热噪声影响,呈现出物理意义上的泊松-高斯分布(Poisson-Gaussian Shot Noise)。在均匀受光的高光和阴影过渡区,噪点分布具备高度各向同性的统计规律。
- 扩散生成模型(Diffusion Models):以 Stable Diffusion、Midjourney、Flux 为代表的模型,其生成过程是基于高斯噪声图逐步执行「反向去噪(Reverse Denoising)」。这种算法在微观像素级会遗留细微的高频空间自相关特征,且在纯色平坦区域往往过于纯净,在纹理区域又会出现异常的高频能量聚集。
端侧算法步骤
- 使用未缩放的 OffscreenCanvas 读取图像的无损像素阵列。
- 提取像素灰度亮度矩阵
Y(x, y)。 - 应用 3x3 离散拉普拉斯高通卷积核(Laplacian Kernel) 过滤掉低频构图与色彩,分离出高频残差图
R(x, y):┌ ┐ │ 0 -1 0 │ │ -1 4 -1 │ │ 0 -1 0 │ └ ┘ - 排除强边缘与高反差轮廓,在低梯度的平滑区域计算残差方差
σ²:σ² = (1/N) · Σ (Rᵢ − R̄)² - 结合方差值和频域能量分布与正常相机传感器基线库进行比对推断。
由于该算法全部在本地通过纯 JavaScript / TypedArray 运算,单张处理耗时仅需 50–150 毫秒,且具备 0 网络延迟。
3. 第三层:云端深度视觉模型推理(可选辅助)
当本地元数据缺失且本地噪点指标处于临界模糊区间时,用户可触发可选的云端深度推理引擎:
- 采用轻量化卷积/视觉 Transformer(ViT)结构,在海量真实与生成样本对上进行过抗压缩鲁棒性训练。
- 对于外部图片 URL,服务器提供具备安全防范(SSRF 攻击拦截、MIME 类型限制、10 MB 大小限制)的代理拉取通道。
四、技术优化与性能考量
在实现该功能时,我们特别注重了前端性能与健壮性:
- 严格的内存生命周期管控:
在前端批量载入高分辨率大图时,极易造成浏览器内存溢出(OOM)。我们在每次图片移除、批量清空以及组件卸载(
useEffect cleanup)时,均显式调用URL.revokeObjectURL释放 Blob 对象引用,确保长时间运行内存平稳。 - 异步批处理与非阻塞渲染: 像素矩阵计算采用微任务分片(Chunking),确保在大批量图片拖入时页面仍保持 60 FPS 流畅响应,按钮与进度条无卡顿。
- 健壮的错误降级防护: 对于部分非标封装的破损 EXIF 数据或格式异常图片(例如仅具有图片扩展名但实际是 HTML 的链接),设置了全局捕获与友好降级提示,避免应用白屏崩溃。
五、检测局限性与使用注意事项
客观认识技术边界对于合理使用工具至关重要。我们在使用 AI 检测器时需注意以下几点:
1. 社交网络与即时通讯软件的元数据清洗
微信、微博、Instagram、Twitter/X 等社交网络在图片上传时,出于用户隐私保护及带宽节省,会自动强制剔除所有 EXIF、IPTC 和 C2PA 凭据并执行大幅度有损压缩。因此,直接从社交媒体上保存的图片,元数据层基本无法找到原始工具痕迹。
2. 重度二次编辑与压缩伪影
若 AI 生成的图片经过了多次高强度有损压缩(JPEG Quality < 60)、添加了重度胶片噪点滤镜(Film Grain)或被二次截屏涂鸦,原有的高频残差结构会被人为噪点覆盖,可能会影响判定精度。
3. 数码插画、CG 渲染与手绘作品
3D 渲染图(Blender / C4D)、矢量插画或扁平手绘由于缺少物理相机传感器的光学噪点,其纯色平滑度很高,可能容易与 AI 生成的平滑表面混淆。建议在分析插画类作品时,结合内容语义综合判断。
4. 隐形数字水印(如 Google SynthID)
部分科技巨头在模型潜在向量空间(Latent Space)直接嵌入的抗剪裁隐形水印(例如 Google DeepMind SynthID),需要专有服务器与私钥才能解密提取,无法在公开的浏览器端直接离线解码。
💡 建议:AI 检测结果应当作为辅助判断的重要线索与证据参考,而非唯一的法律判定标准。遇到关键内容时,建议结合上下文背景、物理合理性(如手指关节、文字逻辑、反射阴影)及发布源头进行多方交叉验证。
六、立即体验
体验全新的 ImageSizeFinder 免费 AI 图片检测器:
- 支持单图/多图批量拖拽上传与剪贴板极速粘贴;
- 展开即可查阅详尽的来源标记、生成参数与技术证据;
- 完全免费,保护隐私,无须下载安装任何客户端。
参考文献与权威资料
- 01.ExifReader — Fast JavaScript image metadata parsing librarygithub.com/mattiasw/ExifReader
- 02.
- 03.Content Authenticity Initiative (CAI) — Open source provenance toolscontentauthenticity.org/
- 04.IPTC Photo Metadata Standard & Digital Source Type Vocabularyiptc.org/standards/photo-metadata/
- 05.Canvas API & ImageData — MDN Web Docsdeveloper.mozilla.org/en-US/docs/Web/API/Canvas_API
- 06.Discrete Laplace Operator in Digital Image Processing — Wikipediaen.wikipedia.org/wiki/Discrete_Laplace_operator
- 07.WebAssembly — High-performance client-side runtime standardwebassembly.org/
- 08.Google DeepMind SynthID — Imperceptible generative AI watermarkingdeepmind.google/technologies/synthid/
- 09.Stable Diffusion WebUI by AUTOMATIC1111github.com/AUTOMATIC1111/stable-diffusion-webui
- 10.ComfyUI — Powerful modular node-based Stable Diffusion GUIgithub.com/comfyanonymous/ComfyUI