Die rasante Entwicklung generativer künstlicher Intelligenz hat die digitale Bildwelt grundlegend verändert. Modelle wie Midjourney v6, OpenAI DALL-E 3, Stable Diffusion XL, Flux.1 und Google Imagen erzeugen fotorealistische Porträts, Landschaften und Grafiken in Sekundenschnelle.
Diese Entwicklung eröffnet enorme kreative Möglichkeiten, bringt jedoch auch ernsthafte Herausforderungen mit sich: Deepfakes, Desinformationskampagnen, Verunreinigung von Bilddatenbanken und komplexe Urheberrechtsfragen.
Um diesen Herausforderungen transparent zu begegnen, haben wir den Kostenlosen KI-Bilddetektor auf ImageSizeFinder entwickelt. Im Gegensatz zu kommerziellen Plattformen, die kostenpflichtige Abonnements für undurchsichtige Prozentwerte verlangen, setzt unser Werkzeug auf eine datenschutzorientierte Dual-Layer-Architektur, die deterministische Prüfungen direkt in Ihrem Browser durchführt und nachvollziehbare Belege liefert.
In diesem Leitfaden erläutern wir die Funktionsweise, mathematische Grundlagen, Architektur und praktische Grenzen der Erkennung.
 Abbildung 1: Benutzeroberfläche des kostenlosen KI-Bilddetektors auf ImageSizeFinder mit Multi-Source-Eingabe, Stapelverarbeitung und lokaler Browseranalyse.
1. Hauptmerkmale des KI-Bilddetektors
Der Detektor wurde entwickelt, um maximale Geschwindigkeit, vollständigen Datenschutz und analytische Gründlichkeit zu verbinden:
- 100 % kostenlos und unbegrenzt: Keine Registrierung, keine Abonnementgebühren und keine künstlichen täglichen Limits für lokale Browseranalysen.
- Clientseitiger Datenschutz (Zero-Upload): Die Untersuchung von Metadaten und Pixelrauschen findet vollständig in Ihrem Browser mittels WebAssembly und der HTML5 Canvas API statt. Ihre Bilder verlassen Ihren Computer nicht, es sei denn, Sie fordern eine tiefere Cloud-Analyse explizit an.
- Vielfältige Eingabemöglichkeiten:
- Drag-and-Drop einzelner oder mehrerer Bilddateien.
- Dateiauswahl über den betriebssystemweiten Dateimanager.
- Einfügen aus der Zwischenablage: Drücken Sie
Strg+V(bzw.Cmd+Vauf macOS) an beliebiger Stelle auf der Seite, um Screenshots sofort zu analysieren. - Direkte Bild-URL: Fügen Sie einen
https://-Link ein, um Bilder im Netz ohne vorherigen Download zu untersuchen.
- Stapelverarbeitungs-Arbeitsbereich: Laden Sie dutzende Bilder gleichzeitig hoch, behalten Sie den Überblick über Status und Ergebnisse und starten Sie die Analyse mit einem Klick.
- Transparente Nachweise: Klappen Sie jedes analysierte Bild auf, um genau zu sehen, worauf das Urteil beruht: Software-Kennungen, IPTC-Herkunftsnachweise, Generierungs-Prompts und Pixelrauschwerte.
2. Erkennungsarchitektur: Der zweistufige Prüfpfad
Eine zuverlässige Erkennung von KI-Inhalten ist anspruchsvoll, da kein einzelnes Signal universell fehlerfrei ist. Metadaten können entfernt werden, und Bildstrukturen verändern sich durch wiederholte Kompression.
Unser System setzt daher auf eine hierarchische Dual-Layer-Pipeline:
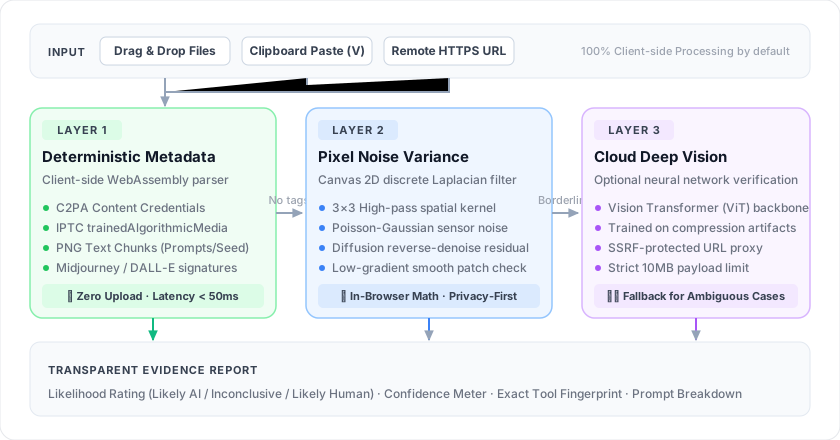 Abbildung 2: Dreistufige progressive Architektur: Schnelle deterministische Metadatenprüfung mit WebAssembly, hochfrequente Canvas-Pixelrauschfaltung und optionale Cloud-Vision-Verifikation.
3. Technische Umsetzung: So arbeiten die Schichten
Schicht 1: Deterministische Metadaten und Herkunftsnachweise
Viele generative KI-Werkzeuge hinterlegen beim Exportieren standardisierte Kennungen. Die erste Schicht nutzt clientseitige Bibliotheken (wie ExifReader), um Bild-Header gezielt zu scannen:
- IPTC Digital Source Type:
- Internationaler Standard für Bildursprünge. KI-Bilder werden hier als
trainedAlgorithmicMediaodercompositeSyntheticdeklariert. - Generatoren wie Google Imagen und Adobe Firefly schreiben diese Werte standardmäßig.
- Internationaler Standard für Bildursprünge. KI-Bilder werden hier als
- IPTC Credit- und Software-Tags:
- Midjourney hinterlegt häufig den String
MidjourneyimCredit- oderSoftware-Feld. - DALL-E 3 fügt spezifische Herstellerkennungen von OpenAI ein.
- Midjourney hinterlegt häufig den String
- PNG-Textblöcke (
tEXt,iTXt,zTXt):- Werkzeuge im Stable Diffusion-Ökosystem (Automatic1111, ComfyUI, Forge) speichern komplette Generierungsdaten im PNG-Header.
- Wir extrahieren Prompts, negative Prompts, Seed, CFG Scale, Sampler und LoRA-Modelle.
- C2PA Content Credentials:
- Nach den Spezifikationen der Content Authenticity Initiative prüfen wir den Bytestrom auf signierte JUMBF-Container mit digitalen Herkunftsnachweisen (
c2pa).
- Nach den Spezifikationen der Content Authenticity Initiative prüfen wir den Bytestrom auf signierte JUMBF-Container mit digitalen Herkunftsnachweisen (
Werden eindeutige Metadaten gefunden, bewertet das System das Bild sofort mit hoher Konfidenz, ohne dass aufwendige Berechnungen nötig sind.
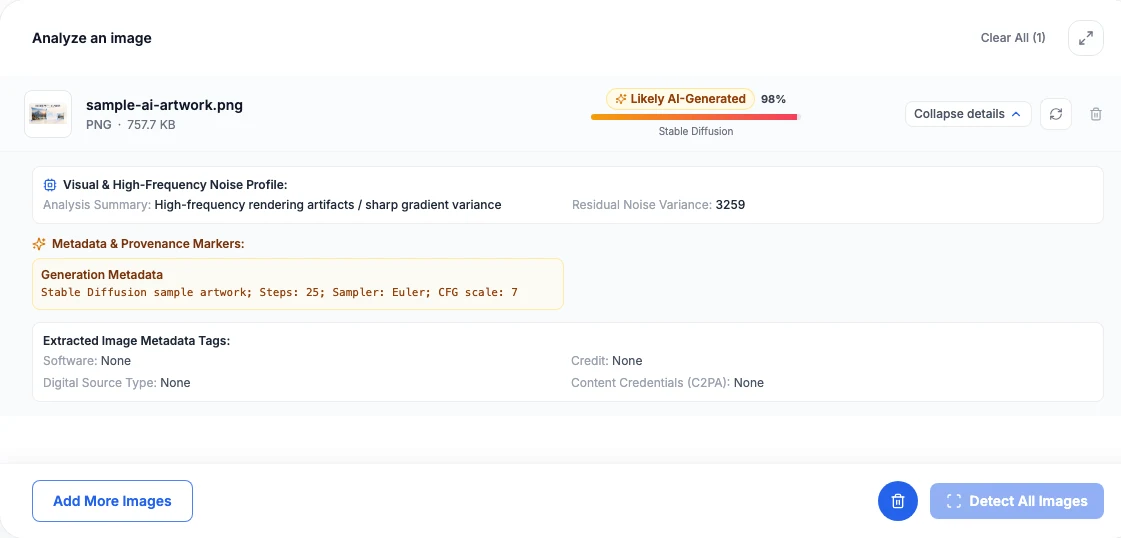 Abbildung 3: Detailliertes Nachweisfenster mit extrahierten Generierungsparametern (Schritte, Sampler, CFG) und Werten zur Rauschvarianz.
Schicht 2: Clientseitige Pixelrausch- und Varianzanalyse
Fehlen Metadaten (beispielsweise nach einer JPEG-Neukonvertierung), führt der Browser eine mathematische Rauschanalyse auf einem unsichtbaren Zeichenbereich mittels OffscreenCanvas und der HTML5 Canvas API durch.
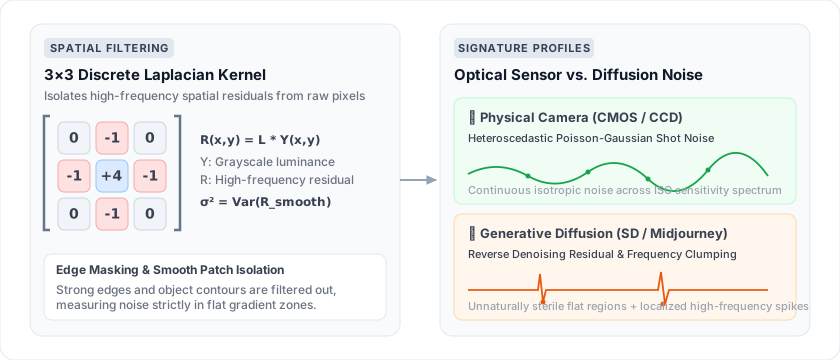 Abbildung 4: Diskrete 3x3-Laplace-Faltung zur Isolierung hochfrequenter Rauschresiduen R(x, y) im Vergleich zwischen physischem Kamerasensor und Diffusionsmodell.
Physikalische und mathematische Grundlagen
- Echte Kamerasensoren: Optische Sensoren (CMOS/CCD) fangen Photonen ein, die Quantenrauschen und thermischem Rauschen unterliegen. Sie folgen einer Poisson-Gauß-Verteilung. In homogenen Flächen weisen reale Aufnahmen ein statistisch gleichmäßiges, isotropes Sensorrauschen auf.
- Diffusionsmodelle: Bildgeneratoren wie Stable Diffusion oder Midjourney erzeugen Bilder schrittweise durch Entrauschen eines anfänglichen Gaußschen Rauschfeldes. Dadurch verbleiben charakteristische hochfrequente Restkorrelationen: Flache Bildbereiche wirken oft unnatürlich glatt, während strukturierte Zonen atypische Frequenzspitzen aufweisen.
Ablauf des Algorithmus
- Das Bild wird unskaliert auf ein
OffscreenCanvasgezeichnet. - Die Rohhelligkeitswerte
Y(x, y)werden mittelsgetImageDataausgelesen. - Ein diskreter 3x3-Laplace-Filter isoliert hochfrequente Residuen
R(x, y):┌ ┐ │ 0 -1 0 │ │ -1 4 -1 │ │ 0 -1 0 │ └ ┘ - Kantenbereiche werden maskiert, um die Restvarianz
σ²auf glatten Flächen zu berechnen:σ² = (1/N) · Σ (Rᵢ − R̄)² - Die ermittelte Varianz wird mit statistischen Profilen realer optischer Sensoren abgeglichen.
Da die Berechnung in JavaScript auf Ihrem Rechner läuft, benötigt sie lediglich 50 bis 150 Millisekunden pro Bild – ohne jegliche Netzwerklatenz.
Schicht 3: Cloud-Deep-Vision-Modell (Optional)
Wenn Metadaten fehlen und die Rauschwerte im Grenzbereich liegen, kann optional ein neuronales Netzwerk in der Cloud zugeschaltet werden:
- Basiert auf Vision-Transformern, die auf Millionen realer und synthetischer Bildpaare trainiert wurden.
- Ermöglicht die sichere Überprüfung entfernter Bild-URLs via
/api/ai-image-detector/fetch-urlmit Schutz vor SSRF-Angriffen und einer 10-MB-Größenbegrenzung.
4. Wichtige Grenzen und Praxishinweise
Kein KI-Detektor ist zu 100 % fehlerfrei. Beachten Sie bei der Auswertung folgende Rahmenbedingungen:
1. Metadatenlöschung durch soziale Netzwerke
Plattformen wie WhatsApp, Instagram oder Twitter/X komprimieren hochgeladene Fotos neu und löschen ausnahmslos alle EXIF-, IPTC- und C2PA-Metadaten. Bei Bildern aus sozialen Netzwerken liefert Schicht 1 daher in der Regel keine Treffer.
2. Nachbearbeitung und starke Kompression
Werden KI-Bilder weichgezeichnet, mit künstlichem Filmkorn überlagert oder stark komprimiert (JPEG-Qualität < 60), werden mikrostrukturelle Merkmale überdeckt, was die Aussagekraft mindern kann.
3. Digitale Kunst und 3D-Renderings
Illustrationen, Vektorgrafiken und 3D-Renderings (Blender, Unreal Engine) weisen naturgemäß kein Kamerasensorrauschen auf. Statistische Rauschanalysatoren können diese Homogenität fälschlicherweise als KI-Signal deuten.
4. Proprietäre unsichtbare Wasserzeichen (SynthID)
Wasserzeichen, die tief im latenten Raum eingebettet sind (wie SynthID von Google DeepMind), erfordern proprietäre Schlüssel und können nicht offline im Browser ausgelesen werden.
💡 Empfehlung: Betrachten Sie Erkennungsergebnisse stets als Hilfestellung und Indizienkette. Prüfen Sie kritische Inhalte immer auch im Gesamtkontext (Bildursprung, Handanatomie, Licht- und Schattenlogik).
5. Jetzt ausprobieren
Möchten Sie ein Bild sofort prüfen?
- Öffnen Sie den Kostenlosen KI-Bilddetektor.
- Ziehen Sie ein Bild in den Bereich, fügen Sie es aus der Zwischenablage ein oder geben Sie eine URL ein.
- Überprüfen Sie den Wahrscheinlichkeitswert, die Konfidenz und klappen Sie das Nachweisfenster für die technischen Details auf.
Referenzen und weiterführende Literatur
- 01.ExifReader — Fast JavaScript image metadata parsing librarygithub.com/mattiasw/ExifReader
- 02.
- 03.Content Authenticity Initiative (CAI) — Open source provenance toolscontentauthenticity.org/
- 04.IPTC Photo Metadata Standard & Digital Source Type Vocabularyiptc.org/standards/photo-metadata/
- 05.Canvas API & ImageData — MDN Web Docsdeveloper.mozilla.org/en-US/docs/Web/API/Canvas_API
- 06.Discrete Laplace Operator in Digital Image Processing — Wikipediaen.wikipedia.org/wiki/Discrete_Laplace_operator
- 07.WebAssembly — High-performance client-side runtime standardwebassembly.org/
- 08.Google DeepMind SynthID — Imperceptible generative AI watermarkingdeepmind.google/technologies/synthid/
- 09.Stable Diffusion WebUI by AUTOMATIC1111github.com/AUTOMATIC1111/stable-diffusion-webui
- 10.ComfyUI — Powerful modular node-based Stable Diffusion GUIgithub.com/comfyanonymous/ComfyUI