El auge de la inteligencia artificial generativa ha transformado profundamente el panorama de los medios visuales. Modelos como Midjourney v6, OpenAI DALL-E 3, Stable Diffusion XL, Flux.1 y Google Imagen son capaces de generar retratos fotorrealistas, paisajes y fotografías con estilo periodístico en cuestión de segundos.
Si bien esto ofrece un potencial creativo sin precedentes, también plantea desafíos urgentes: difusión de desinformación, proliferación de deepfakes, contaminación de bancos de imágenes y controversias sobre derechos de autor.
Frente a esta situación, en ImageSizeFinder desarrollamos el Detector de imágenes IA gratuito. A diferencia de plataformas cerradas que cobran suscripciones a cambio de un porcentaje arbitrario sin justificación, nuestra herramienta se basa en una arquitectura de detección dual centrada en la privacidad, que ejecuta comprobaciones deterministas en tu propio navegador y ofrece pruebas técnicas transparentes y verificables.
En esta guía te explicamos sus funcionalidades clave, principios arquitectónicos, fundamentos matemáticos y limitaciones prácticas.
 Figura 1: Interfaz del detector de imágenes IA gratuito de ImageSizeFinder con entrada multicanal, análisis por lotes y verificación local con total privacidad.
1. Características principales del detector de IA
El detector ha sido diseñado para equilibrar rapidez, confidencialidad y rigor analítico:
- 100% gratuito e ilimitado: Sin registro previo, sin suscripciones de pago y sin límites diarios artificiales para los análisis locales en el navegador.
- Privacidad en el cliente (Zero-Upload): La inspección de metadatos y el análisis de ruido se procesan íntegramente en tu navegador mediante WebAssembly y la API HTML5 Canvas. Tus imágenes nunca abandonan tu dispositivo salvo que solicites explícitamente un análisis neuronal en la nube.
- Múltiples métodos de entrada:
- Arrastra y suelta uno o varios archivos de imagen.
- Selección clásica mediante el explorador de archivos.
- Pegado desde el portapapeles: pulsa
Ctrl+V(oCmd+Ven macOS) en cualquier parte de la página para analizar capturas o imágenes copiadas al instante. - URL directa: pega un enlace
https://para examinar imágenes remotas sin necesidad de descargarlas previamente.
- Espacio de trabajo por lotes: Carga decenas de imágenes a la vez, revisa su estado en una lista unificada y ejecuta la comprobación completa con un solo clic.
- Panel de evidencias transparente: Despliega cualquier imagen analizada para comprender exactamente por qué recibió su puntuación: huellas de software, etiquetas IPTC, parámetros de generación y varianza de ruido.
2. Arquitectura de detección: Flujo en dos capas
Detectar contenido generado por IA de forma fiable es un reto complejo porque ninguna señal por sí sola es infalible. Los metadatos pueden eliminarse y los patrones de píxeles se ven afectados por la recompresión.
Para lograr una precisión equilibrada, nuestro sistema implementa una canalización progresiva de dos capas:
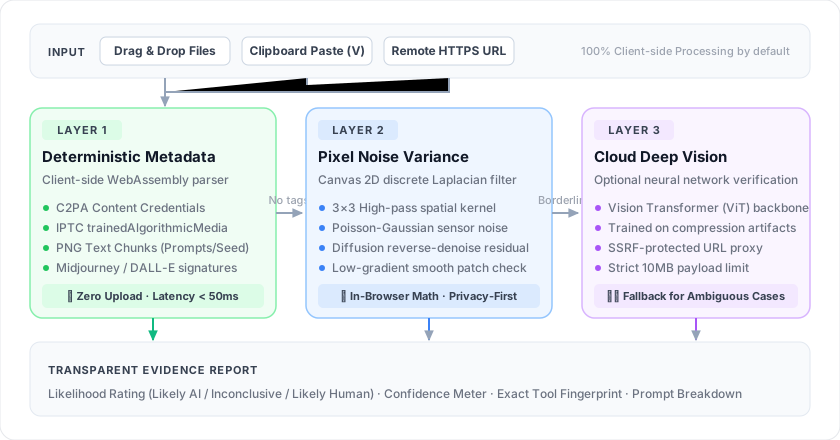 Figura 2: Arquitectura progresiva de tres niveles: verificación determinista de metadatos en WebAssembly, convolución de ruido de píxeles en Canvas e inferencia neuronal opcional en la nube.
3. Detalles de implementación: Cómo funciona cada capa
Capa 1: Metadatos deterministas y trazabilidad de origen
Muchas herramientas de IA generativa incrustan firmas legibles por máquina al exportar sus resultados. La primera capa utiliza bibliotecas cliente especializadas (como ExifReader) para escanear los bytes de la imagen:
- IPTC Digital Source Type (Tipo de fuente digital):
- Estándar internacional en el que las imágenes sintéticas se marcan como
trainedAlgorithmicMedia(generada por algoritmo entrenado) ocompositeSynthetic(medio sintético compuesto). - Generadores como Google Imagen y Adobe Firefly escriben sistemáticamente estos campos.
- Estándar internacional en el que las imágenes sintéticas se marcan como
- Etiquetas IPTC Credit y Software:
- Herramientas como Midjourney suelen incluir la marca
Midjourneyen los camposCreditoSoftware. - DALL-E 3 introduce etiquetas específicas que identifican la creación por parte de OpenAI.
- Herramientas como Midjourney suelen incluir la marca
- Bloques de texto en archivos PNG (
tEXt,iTXt,zTXt):- Ecosistemas de Stable Diffusion (Automatic1111, ComfyUI, Forge) guardan los parámetros completos en la cabecera PNG.
- Extraemos prompts positivos y negativos, semilla (seed), escala CFG, muestreador (sampler) y nombres de modelos LoRA.
- Credenciales de contenido C2PA:
- Conforme a la iniciativa de autenticidad Content Authenticity Initiative, inspeccionamos el flujo de bytes en busca de contenedores JUMBF con manifiestos criptográficos de procedencia (
c2pa).
- Conforme a la iniciativa de autenticidad Content Authenticity Initiative, inspeccionamos el flujo de bytes en busca de contenedores JUMBF con manifiestos criptográficos de procedencia (
Si se localizan estas evidencias deterministas, el sistema clasifica la imagen con alta confianza sin necesidad de cálculos adicionales.
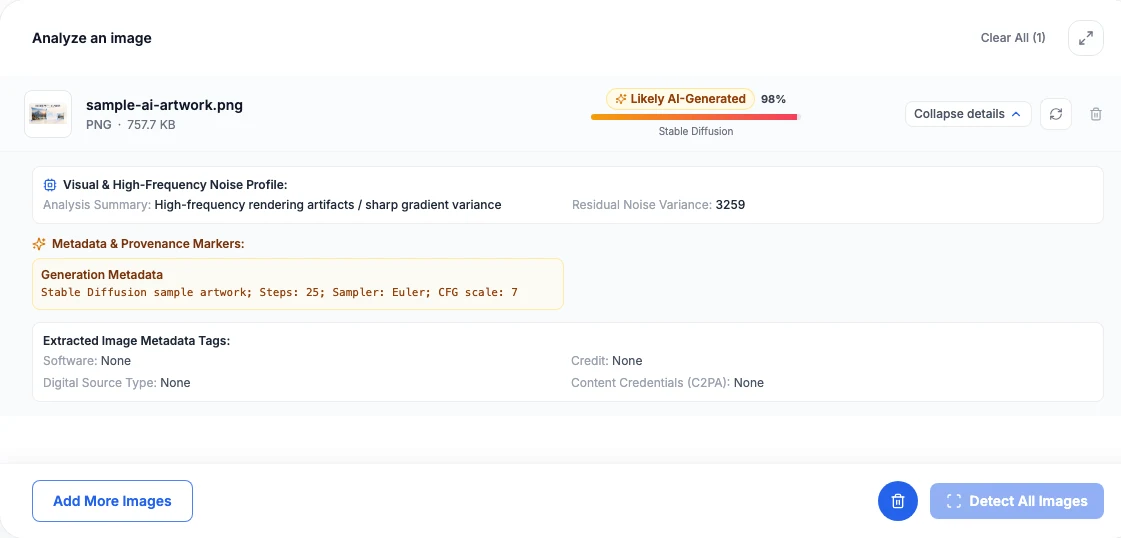 Figura 3: Panel de evidencias desplegado que muestra los parámetros de generación detectados (pasos, muestreador, CFG) junto con las métricas de varianza de ruido.
Capa 2: Análisis de varianza de ruido de píxeles en el navegador
Cuando una imagen no contiene metadatos (por haber sido convertida a JPEG o limpiada por software), el navegador activa un análisis matemático de varianza espacial en un lienzo fuera de pantalla mediante OffscreenCanvas y HTML5 Canvas.
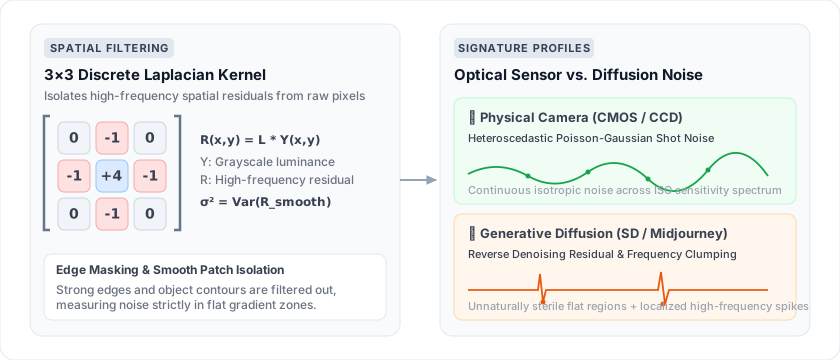 Figura 4: Convolución espacial discreta de Laplace 3x3 que aísla el residuo de alta frecuencia R(x, y), contrastando el ruido físico del sensor óptico con los artefactos de difusión.
Fundamento físico y matemático
- Cámaras digitales reales: Los sensores ópticos físicos (CMOS/CCD) captan fotones sujetos a ruido de disparo fotónico y fluctuaciones térmicas, siguiendo una distribución estadística Poisson-Gaussiana. En zonas homogéneas de sombras y luces, el grano del sensor presenta propiedades isotrópicas bien definidas.
- Modelos de difusión generativa: Herramientas como Midjourney o Stable Diffusion generan imágenes mediante un proceso iterativo de eliminación de ruido a partir de ruido gaussiano inicial. Esto suele dejar correlaciones espaciales microscópicas, con áreas lisas excesivamente uniformes o concentraciones atípicas de energía en altas frecuencias.
Algoritmo paso a paso
- La imagen se dibuja en un
OffscreenCanvassin reescalado. - Se extrae la matriz de luminancia en escala de grises
Y(x, y)mediantegetImageData. - Se aplica un filtro espacial discreto de Laplace de 3x3 para aislar el residuo de alta frecuencia
R(x, y):┌ ┐ │ 0 -1 0 │ │ -1 4 -1 │ │ 0 -1 0 │ └ ┘ - Se descartan los bordes pronunciados y se calcula la varianza residual
σ²en regiones suaves:σ² = (1/N) · Σ (Rᵢ − R̄)² - Los valores obtenidos se cotejan con perfiles empíricos de sensores fotográficos reales.
Al procesarse íntegramente en JavaScript del lado del cliente, la operación tarda entre 50 y 150 milisegundos por imagen, con latencia de red cero.
Capa 3: Motor de visión profunda en la nube (Opcional)
Si los metadatos fueron eliminados y las métricas de ruido se encuentran en un umbral dudoso, el usuario puede recurrir a un modelo neuronal en la nube:
- Basado en arquitecturas ligeras de visión por computador (Vision Transformers) entrenadas con millones de pares de imágenes reales y sintéticas.
- Gestiona el análisis seguro de URLs externas a través de
/api/ai-image-detector/fetch-url, con protección contra ataques SSRF, lista blanca de formatos y límite de 10 MB.
4. Limitaciones técnicas y recomendaciones
Ningún detector de IA es infalible al 100%. Para una correcta interpretación de los diagnósticos, ten en cuenta los siguientes factores:
1. Eliminación de datos en redes sociales
Redes como WhatsApp, Instagram o Twitter/X recomprimen sistemáticamente los archivos y eliminan por completo los metadatos EXIF, IPTC y C2PA. Una imagen descargada de redes carecerá de pistas en la Capa 1 aunque haya sido creada con Midjourney.
2. Edición posterior y compresión fuerte
Aplicar filtros de desenfoque, grano artificial de película o compresión JPEG agresiva (calidad < 60) altera la estructura fina de los píxeles, pudiendo atenuar la precisión del análisis.
3. Ilustraciones digitales y renderizado 3D
Las imágenes 3D (Blender, Unreal Engine) o el arte vectorial carecen de ruido de sensor óptico por naturaleza. Los estimadores estadísticos pueden interpretar esta pureza como señal artificial. Conviene valorar siempre el formato artístico del contenido.
4. Marcas de agua latentes propietarias (SynthID)
Marcas invisibles insertadas en el espacio latente de difusión (como SynthID de Google DeepMind) precisan de claves privadas y servidores autorizados para su decodificación, no pudiendo leerse de forma offline en un navegador estándar.
💡 Consejo: Utiliza los resultados del detector como una herramienta de apoyo objetiva. Ante contenidos críticos, contrasta los datos con el contexto de publicación y la coherencia visual física (anatomía, reflejos, sombras).
5. Empieza a analizar imágenes
¿Quieres comprobar la autenticidad de una imagen?
- Accede al Detector de imágenes IA gratuito.
- Arrastra una imagen, pégala desde el portapapeles o escribe una URL.
- Examina la probabilidad estimada, el nivel de confianza y despliega el desglose de evidencias para consultar los datos técnicos.
Referencias y lecturas recomendadas
- 01.ExifReader — Fast JavaScript image metadata parsing librarygithub.com/mattiasw/ExifReader
- 02.
- 03.Content Authenticity Initiative (CAI) — Open source provenance toolscontentauthenticity.org/
- 04.IPTC Photo Metadata Standard & Digital Source Type Vocabularyiptc.org/standards/photo-metadata/
- 05.Canvas API & ImageData — MDN Web Docsdeveloper.mozilla.org/en-US/docs/Web/API/Canvas_API
- 06.Discrete Laplace Operator in Digital Image Processing — Wikipediaen.wikipedia.org/wiki/Discrete_Laplace_operator
- 07.WebAssembly — High-performance client-side runtime standardwebassembly.org/
- 08.Google DeepMind SynthID — Imperceptible generative AI watermarkingdeepmind.google/technologies/synthid/
- 09.Stable Diffusion WebUI by AUTOMATIC1111github.com/AUTOMATIC1111/stable-diffusion-webui
- 10.ComfyUI — Powerful modular node-based Stable Diffusion GUIgithub.com/comfyanonymous/ComfyUI