L'essor fulgurant de l'intelligence artificielle générative a profondément transformé la création visuelle. Des modèles tels que Midjourney v6, OpenAI DALL-E 3, Stable Diffusion XL, Flux.1 et Google Imagen sont capables de concevoir des portraits hyperréalistes, des paysages et des illustrations en quelques secondes.
Cette révolution apporte une créativité sans précédent, mais engendre aussi des défis majeurs : prolifération des deepfakes, désinformation en ligne, pollution des banques d'images et litiges sur les droits d'auteur.
Pour répondre à ces enjeux, ImageSizeFinder a conçu le Détecteur d'images IA gratuit. Contrairement aux solutions fermées qui imposent des abonnements payants pour un score opaque, notre outil repose sur une architecture d'analyse double et respectueuse de la vie privée, effectuant des contrôles déterministes directement dans votre navigateur et fournissant des preuves techniques vérifiables.
Dans ce guide, nous détaillons ses fonctionnalités clés, son architecture, ses fondements mathématiques et ses limites pratiques.
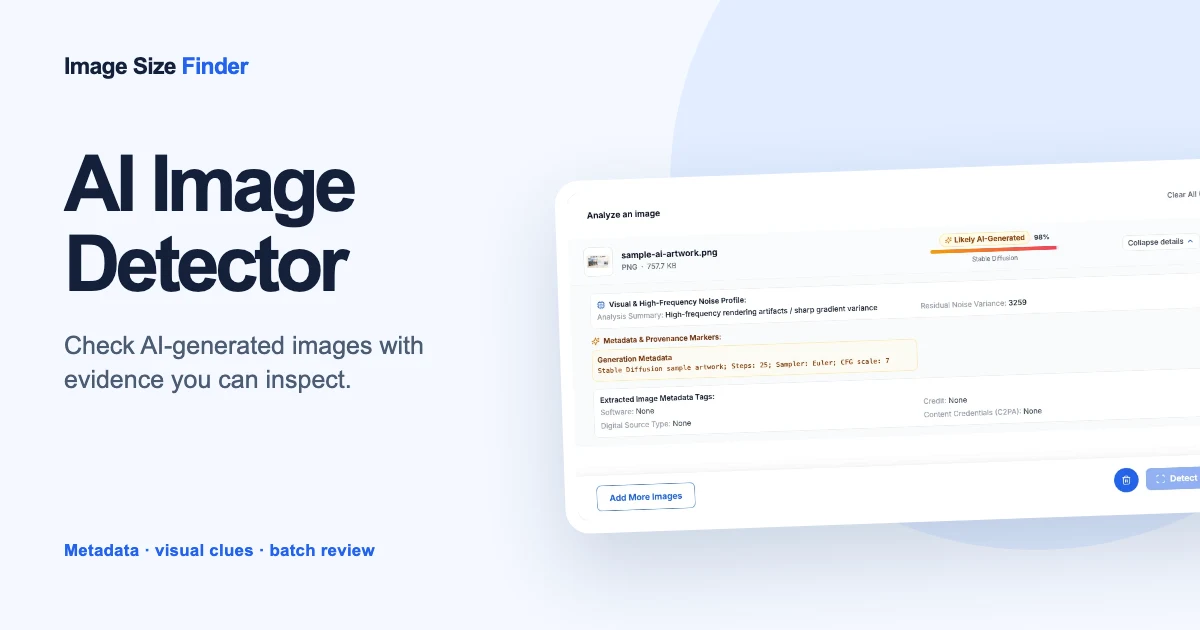 Figure 1 : Interface du détecteur d'images IA gratuit ImageSizeFinder avec saisie multi-sources, analyse par lot et vérification locale confidentielle.
1. Principales caractéristiques du détecteur d'IA
Le détecteur a été développé pour concilier rapidité, confidentialité et rigueur analytique :
- 100 % gratuit et illimité : Aucune création de compte requise, aucun abonnement, et aucune limite journalière arbitraire pour les analyses locales dans le navigateur.
- Confidentialité sur le poste client (Zero-Upload) : L'extraction des métadonnées et l'analyse du bruit des pixels s'exécutent entièrement dans votre navigateur grâce à WebAssembly et à l'API HTML5 Canvas. Vos images ne quittent jamais votre appareil, sauf demande explicite d'analyse neuronale sur serveur.
- Modes de saisie multiples :
- Glisser-déposer d'un ou plusieurs fichiers d'images.
- Sélection classique via le gestionnaire de fichiers.
- Collage direct depuis le presse-papier : utilisez
Ctrl+V(ouCmd+Vsur macOS) n'importe où sur la page pour inspecter une capture d'écran en un instant. - URL directe : collez un lien
https://pour analyser une image distante sans téléchargement préalable.
- Espace de traitement par lot : Déposez des dizaines d'images, suivez leur statut dans une vue unifiée et déclenchez l'analyse globale en un clic.
- Panneau de preuves transparent : Dépliez n'importe quelle image inspectée pour visualiser le détail des critères : signatures logicielles, balises IPTC, prompts de génération et variance du bruit résiduel.
2. Architecture de détection : Pipeline en deux couches
Identifier de manière fiable un contenu généré par IA est un défi complexe car aucun indicateur n'est infaillible à lui seul. Les métadonnées peuvent être supprimées et la compression altère les structures de pixels.
Notre système applique une stratégie progressive à double niveau :
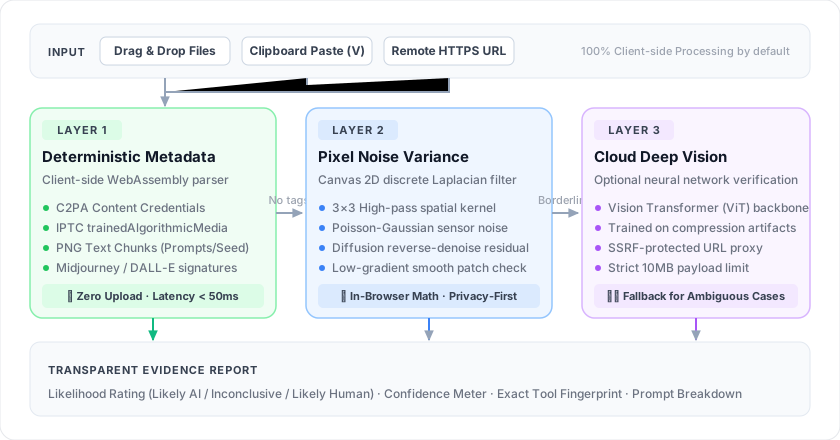 Figure 2 : Architecture progressive à trois niveaux : filtrage déterministe des métadonnées sous WebAssembly, convolution du bruit de pixels sur Canvas et inférence neuronale optionnelle dans le cloud.
3. Détails d'implémentation : Le rôle de chaque couche
Couche 1 : Métadonnées déterministes et traçabilité d'origine
La plupart des moteurs de génération intègrent des signatures lisibles par machine lors de l'enregistrement des fichiers. La première couche s'appuie sur des bibliothèques clientes spécialisées (comme ExifReader) pour inspecter les flux binaires :
- IPTC Digital Source Type (Type de source numérique) :
- Norme internationale où les médias générés sont désignés par
trainedAlgorithmicMedia(génération algorithmique) oucompositeSynthetic(média synthétique). - Les moteurs comme Google Imagen ou Adobe Firefly renseignent systématiquement cette information.
- Norme internationale où les médias générés sont désignés par
- Balises IPTC Credit et Software :
- Midjourney inclut fréquemment la mention
Midjourneydans le champCreditouSoftware. - DALL-E 3 inscrit des marqueurs reconnaissables identifiant la création par OpenAI.
- Midjourney inclut fréquemment la mention
- Blocs de texte PNG (
tEXt,iTXt,zTXt) :- Les interfaces de Stable Diffusion (Automatic1111, ComfyUI, Forge) stockent l'ensemble des paramètres dans l'en-tête PNG.
- Nous extrayons le prompt positif, le prompt négatif, la graine (seed), le facteur CFG, le sampler et les modèles LoRA utilisés.
- Identifiants de contenu C2PA :
- Conformément aux spécifications de la Content Authenticity Initiative, l'outil recherche les conteneurs JUMBF renfermant des certificats cryptographiques d'authenticité (
c2pa).
- Conformément aux spécifications de la Content Authenticity Initiative, l'outil recherche les conteneurs JUMBF renfermant des certificats cryptographiques d'authenticité (
Lorsqu'une preuve déterministe est confirmée, l'image est immédiatement classifiée avec une confiance élevée, sans nécessiter de calculs lourds.
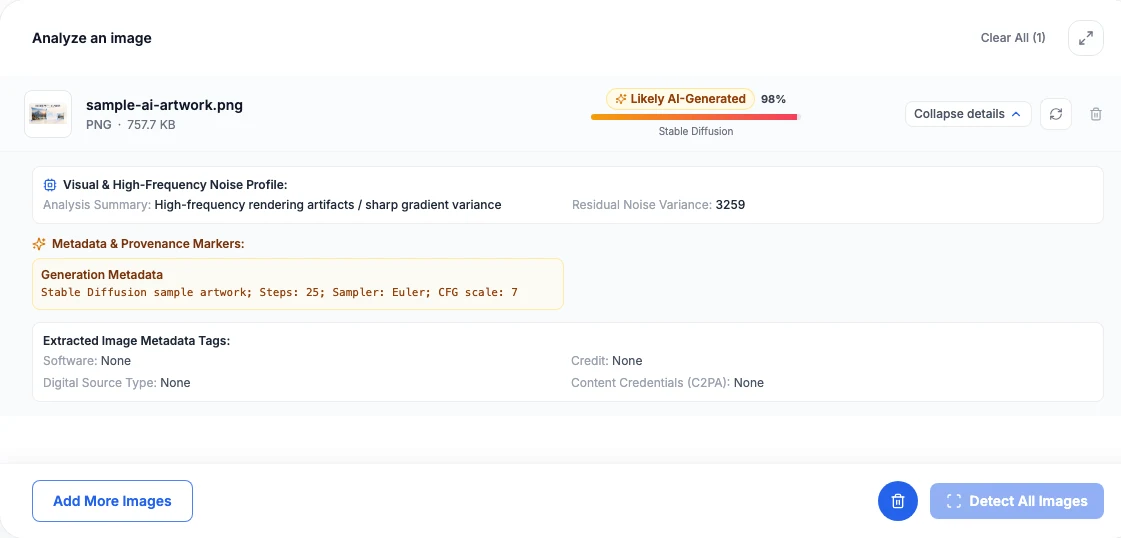 Figure 3 : Détail du panneau d'indices présentant les paramètres de génération identifiés (échantillonneur, CFG, étapes) et les métriques de bruit résiduel.
Couche 2 : Analyse de variance du bruit de pixels dans le navigateur
Lorsqu'une image est dépourvue de métadonnées (après conversion en JPEG ou nettoyage externe), le navigateur effectue une analyse spatiale statistique au moyen d'OffscreenCanvas et de l'API HTML5 Canvas.
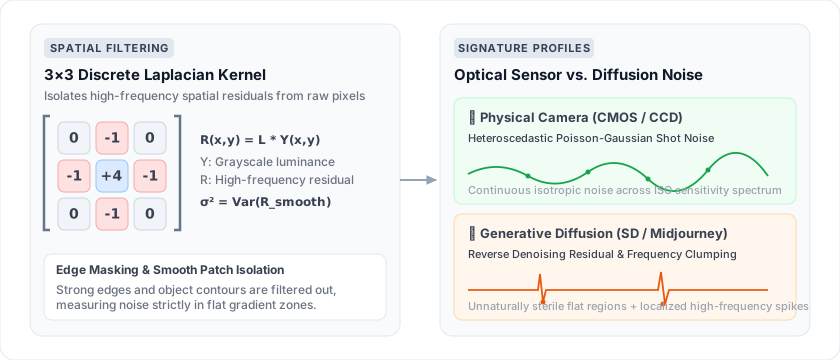 Figure 4 : Convolution spatiale discrète de Laplace 3x3 isolant le résidu de haute fréquence R(x, y), comparant le bruit physique d'un capteur optique aux artefacts de débruitage par diffusion.
Fondements physiques et mathématiques
- Capteurs photographiques réels : Les appareils photo physiques (capteurs CMOS/CCD) capturent des photons soumis au bruit de grenaille quantique et aux fluctuations thermiques, modélisés par une distribution statistique de Poisson-Gauss. Le grain présente une cohérence isotrope naturelle sur les zones lisses.
- Modèles de diffusion : Les générateurs comme Stable Diffusion ou Midjourney créent des images par débruitage itératif à partir d'un bruit blanc gaussien initial. Ce processus laisse de légères corrélations spatiales en haute fréquence, avec des zones plates souvent trop pures et des concentrations anormales de fréquences dans les textures.
Étapes de l'algorithme
- Le fichier est projeté sur un
OffscreenCanvassans altération d'échelle. - La luminance brute
Y(x, y)est extraite viagetImageData. - Un noyau de convolution laplacien discret 3x3 isole le résidu de haute fréquence
R(x, y):┌ ┐ │ 0 -1 0 │ │ -1 4 -1 │ │ 0 -1 0 │ └ ┘ - Les arêtes vives sont éliminées pour calculer la variance résiduelle
σ²sur les surfaces lisses :σ² = (1/N) · Σ (Rᵢ − R̄)² - La variance et l'énergie spectrale sont comparées aux signatures caractéristiques des capteurs numériques réels.
Ce traitement s'exécute en pur JavaScript côté client en 50 à 150 millisecondes par image, avec une latence réseau nulle.
Couche 3 : Moteur de vision profonde sur serveur (Optionnel)
Si les métadonnées sont absentes et que les valeurs de bruit se situent dans une zone d'incertitude, l'utilisateur peut interroger un modèle de vision par ordinateur sur serveur :
- Architecture neuronale basée sur des Vision Transformers entraînés sur de vastes collections d'images réelles et synthétiques.
- Sécurisation de l'analyse d'URL distantes via
/api/ai-image-detector/fetch-urlavec protection contre les attaques SSRF et contrôle des formats autorisés.
4. Limites techniques et recommandations d'usage
Aucun système de détection n'est fiable à 100 %. Gardez à l'esprit les spécificités suivantes lors de l'évaluation d'une image :
1. Compression sur les réseaux sociaux
Les plateformes comme WhatsApp, Instagram ou Twitter/X réencodent systématiquement les fichiers et suppriment toutes les métadonnées EXIF, IPTC et C2PA. Une image téléchargée depuis ces services ne contiendra aucune trace en Couche 1, même si elle provient initialement de Midjourney.
2. Retouches poussées et recompression
L'application de flous gaussiens, de filtres de grain de pellicule ou d'une forte compression JPEG (qualité < 60) dégrade les détails fins des pixels, ce qui peut réduire la précision de l'analyse.
3. Illustration numérique et rendu 3D
Les créations 3D (Blender, Unreal Engine) ou les dessins vectoriels ne comportent naturellement aucun bruit de capteur optique. Les algorithmes statistiques peuvent parfois interpréter cette pureté comme une signature synthétique.
4. Filigranes invisibles propriétaires (SynthID)
Certains filigranes intégrés au cœur des tenseurs latents (comme SynthID de Google DeepMind) nécessitent des clés privées pour être déchiffrés et ne peuvent pas être lus hors ligne dans un navigateur web standard.
💡 Recommandation : Considérez les résultats de détection comme des indices d'aide à la décision. Pour des contenus sensibles, croisez toujours ces données avec le contexte de diffusion et la cohérence visuelle globale (mains, reflets, ombres).
5. Comment commencer
Prêt à inspecter vos premières photos ?
- Rendez-vous sur le Détecteur d'images IA gratuit.
- Glissez votre fichier, collez depuis le presse-papier ou saisissez une URL directe.
- Consultez l'indice de probabilité, le niveau de confiance et ouvrez le volet d'indices pour examiner les données techniques.
Références et lectures complémentaires
- 01.ExifReader — Fast JavaScript image metadata parsing librarygithub.com/mattiasw/ExifReader
- 02.
- 03.Content Authenticity Initiative (CAI) — Open source provenance toolscontentauthenticity.org/
- 04.IPTC Photo Metadata Standard & Digital Source Type Vocabularyiptc.org/standards/photo-metadata/
- 05.Canvas API & ImageData — MDN Web Docsdeveloper.mozilla.org/en-US/docs/Web/API/Canvas_API
- 06.Discrete Laplace Operator in Digital Image Processing — Wikipediaen.wikipedia.org/wiki/Discrete_Laplace_operator
- 07.WebAssembly — High-performance client-side runtime standardwebassembly.org/
- 08.Google DeepMind SynthID — Imperceptible generative AI watermarkingdeepmind.google/technologies/synthid/
- 09.Stable Diffusion WebUI by AUTOMATIC1111github.com/AUTOMATIC1111/stable-diffusion-webui
- 10.ComfyUI — Powerful modular node-based Stable Diffusion GUIgithub.com/comfyanonymous/ComfyUI