L'espansione dell'intelligenza artificiale generativa ha trasformato radicalmente il mondo dei contenuti visivi. Modelli avanzati come Midjourney v6, OpenAI DALL-E 3, Stable Diffusion XL, Flux.1 e Google Imagen possono sintetizzare ritratti fotografici, paesaggi e illustrazioni di straordinario realismo in pochi istanti.
Sebbene ciò apra prospettive creative illimitate, comporta anche serie complessità: diffusione di fake news, deepfake ingannevoli, inquinamento delle librerie fotografiche e questioni sul diritto d'autore.
Per affrontare queste sfide in modo trasparente, ImageSizeFinder ha creato il Rilevatore di immagini AI gratuito. A differenza di molti servizi a pagamento che restituiscono una percentuale opaca senza spiegazioni, il nostro strumento adotta un'architettura di rilevamento duale incentrata sulla privacy, eseguendo verifiche deterministiche direttamente nel tuo browser e offrendo evidenze tecniche consultabili.
In questa guida analizziamo funzionalità, fondamenti matematici, struttura tecnica e limiti pratici della rilevazione.
 Figura 1: Interfaccia del rilevatore di immagini AI gratuito di ImageSizeFinder con caricamento multi-sorgente, analisi batch e verifica locale con totale rispetto della privacy.
1. Caratteristiche principali del rilevatore di immagini AI
Lo strumento è stato progettato per garantire velocità, riservatezza e rigore analitico:
- 100% gratuito e senza limiti: Nessuna registrazione necessaria, nessun abbonamento e nessun tetto giornaliero per le verifiche eseguite nel browser.
- Privacy garantita sul dispositivo (Zero-Upload): L'estrazione dei metadati e il calcolo del rumore dei pixel avvengono interamente nel tuo browser grazie a WebAssembly e all'API HTML5 Canvas. Le immagini non vengono inviate a server esterni, a meno che non si richieda esplicitamente l'analisi neurale cloud.
- Metodi di inserimento flessibili:
- Trascina e rilascia uno o più file di immagini.
- Selezione classica tramite finestra di dialogo del sistema operativo.
- Incolla dagli appunti: premi
Ctrl+V(oCmd+Vsu macOS) ovunque sulla pagina per analizzare schermate o immagini copiate al volo. - URL diretta: incolla un indirizzo
https://per esaminare immagini sul web senza doverle prima scaricare.
- Area di lavoro batch: Carica decine di foto contemporaneamente, monitora lo stato di ciascuna ed esegui la verifica collettiva con un solo clic.
- Pannello delle evidenze trasparente: Espandi qualsiasi elemento analizzato per comprendere esattamente le ragioni del punteggio: firme software, tag IPTC, prompt di generazione e varianza del rumore residuo.
2. Architettura di rilevamento: Flusso a due livelli
Riconoscere immagini generate da intelligenza artificiale è un compito complesso poiché nessun singolo indicatore è infallibile. I metadati possono essere rimossi e la compressione altera la microstruttura dei pixel.
Il nostro sistema impiega una pipeline progressiva a due livelli:
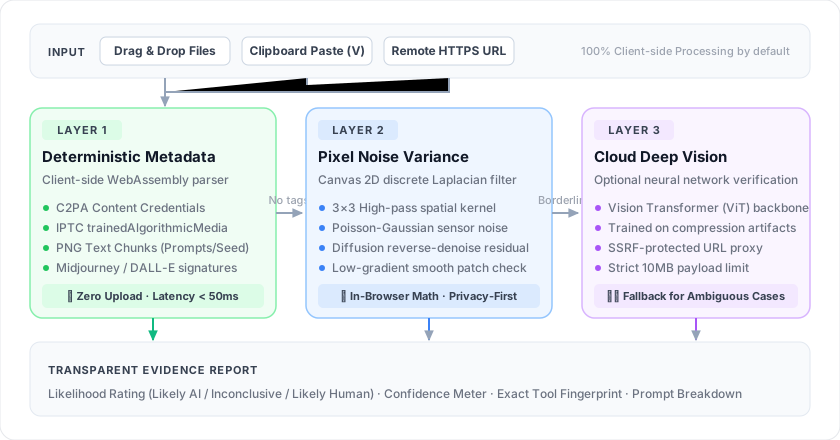 Figura 2: Architettura progressiva a tre livelli: scansione rapida dei metadati in WebAssembly, convoluzione spaziale del rumore su Canvas e inferenza neurale cloud opzionale.
3. Dettagli implementativi: Il funzionamento dei livelli
Livello 1: Metadati deterministici e provenienza
Molti generatori di intelligenza artificiale inseriscono marcatori leggibili dai software al momento del salvataggio. Il primo livello utilizza librerie client specializzate (come ExifReader) per analizzare i byte dell'immagine:
- IPTC Digital Source Type (Tipo di origine digitale):
- Standard internazionale in cui i contenuti sintetici vengono etichettati come
trainedAlgorithmicMediaocompositeSynthetic. - Google Imagen e Adobe Firefly compilano costantemente questo attributo.
- Standard internazionale in cui i contenuti sintetici vengono etichettati come
- Tag IPTC Credit e Software:
- Midjourney include spesso il riferimento
Midjourneynei campiCreditoSoftware. - DALL-E 3 inserisce descrittori specifici che indicano la provenienza da OpenAI.
- Midjourney include spesso il riferimento
- Blocchi di testo PNG (
tEXt,iTXt,zTXt):- Gli strumenti dell'ecosistema Stable Diffusion (Automatic1111, ComfyUI, Forge) incorporano i dati di generazione nell'intestazione del file PNG.
- Il rilevatore estrae prompt positivi e negativi, valore seed, scala CFG, sampler e modelli LoRA.
- Credenziali di contenuto C2PA:
- In conformità con la Content Authenticity Initiative, ricerchiamo la presenza di contenitori JUMBF che racchiudono certificati crittografici di provenienza (
c2pa).
- In conformità con la Content Authenticity Initiative, ricerchiamo la presenza di contenitori JUMBF che racchiudono certificati crittografici di provenienza (
Se vengono riscontrate evidenze deterministiche certe, l'immagine viene contrassegnata con alta confidenza, senza richiedere ulteriori elaborazioni.
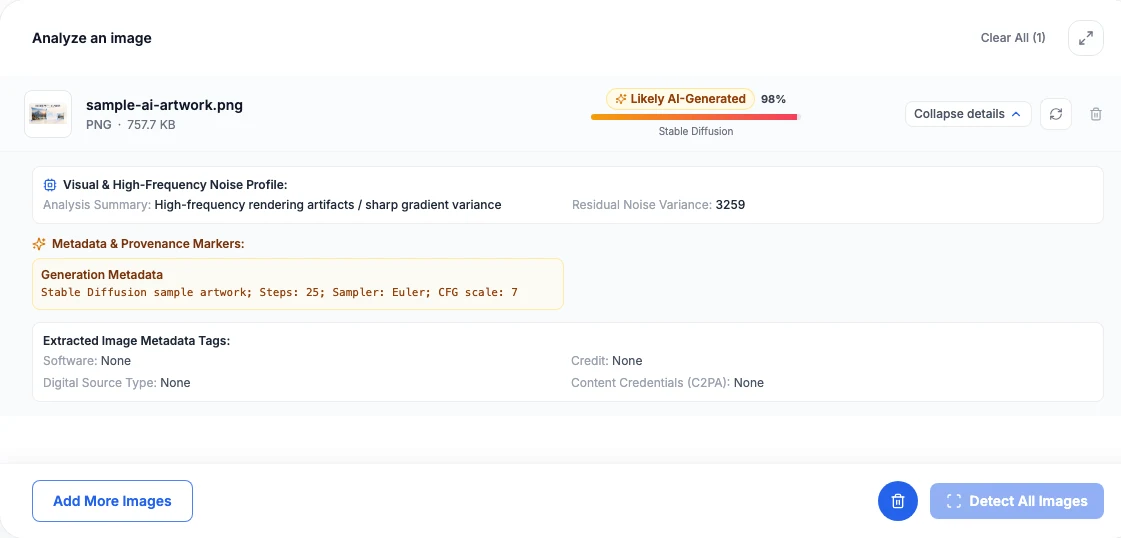 Figura 3: Schermata dei dettagli con parametri di generazione identificati (passaggi, campionatore, scala CFG) e metriche di varianza del rumore residuo.
Livello 2: Analisi della varianza del rumore dei pixel nel browser
Quando un'immagine è priva di metadati (ad esempio dopo una conversione in JPEG o una pulizia intenzionale), il browser avvia un'analisi spaziale statistica su un canvas fuori schermo tramite OffscreenCanvas e l'API HTML5 Canvas.
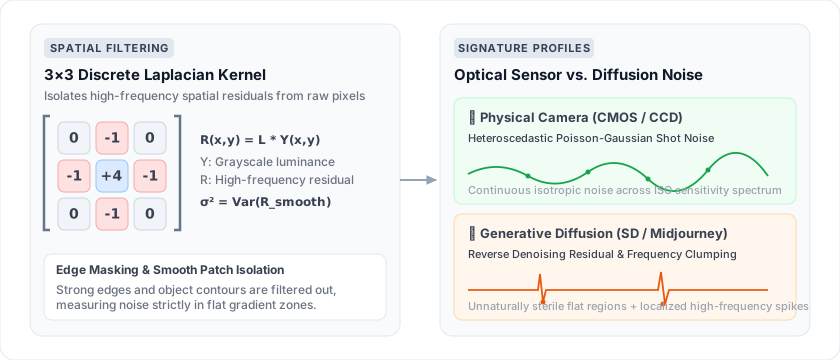 Figura 4: Convoluzione discreta laplaciana 3x3 che isola il rumore residuo ad alta frequenza R(x, y), mettendo a confronto il sensore ottico reale e i modelli di diffusione.
Basi fisiche e matematiche
- Sensori fotografici reali: I sensori ottici fisici (CMOS/CCD) catturano fotoni soggetti al rumore quantico di shot e alle fluttuazioni termiche, descritti da una distribuzione Poisson-Gaussiana. Nelle aree uniformi di luci e ombre, il rumore del sensore mostra una chiara consistenza isotropa.
- Modelli generativi di diffusione: Algoritmi come Stable Diffusion o Midjourney generano immagini mediante denoise iterativo a partire da un campo di rumore gaussiano iniziale. Questo lascia correlazioni microscopiche ad alta frequenza: le aree piatte risultano spesso eccessivamente uniformi, mentre le superfici con texture mostrano picchi anomali.
Fasi dell'algoritmo
- L'immagine viene renderizzata su un
OffscreenCanvassenza scalatura. - I valori grezzi di luminanza
Y(x, y)vengono estratti tramitegetImageData. - Un operatore discreto laplaciano 3x3 isola i residui ad alta frequenza
R(x, y):┌ ┐ │ 0 -1 0 │ │ -1 4 -1 │ │ 0 -1 0 │ └ ┘ - Vengono esclusi i bordi netti per calcolare la varianza residua
σ²sulle zone piatte:σ² = (1/N) · Σ (Rᵢ − R̄)² - I risultati vengono confrontati con i profili statistici standard dei sensori digitali.
Eseguito interamente in JavaScript sul dispositivo dell'utente, questo calcolo richiede appena 50-150 millisecondi per immagine, senza alcuna attesa di rete.
Livello 3: Modello di visione profonda in cloud (Opzionale)
Nei casi in cui i metadati siano assenti e i valori di rumore ricadano in una fascia di incertezza, è possibile consultare un modello neurale su server:
- Basato su Vision Transformers addestrati su milioni di esempi reali e sintetici.
- Gestisce l'analisi sicura di URL esterne tramite
/api/ai-image-detector/fetch-url, applicando filtri contro attacchi SSRF e verificando il limite di dimensione di 10 MB.
4. Limiti pratici e considerazioni d'uso
Nessun rilevatore di intelligenza artificiale è affidabile al 100%. Nella valutazione dei risultati è fondamentale tenere presenti questi fattori:
1. Rimozione dei metadati da parte dei social network
Piattaforme come WhatsApp, Instagram o X ricomprimono le immagini caricate e cancellano sistematicamente tutti i metadati EXIF, IPTC e C2PA. Un'immagine scaricata da un social non presenterà tracce nel Livello 1, anche se generata originariamente con Midjourney.
2. Modifiche successive e compressione aggressiva
L'applicazione di filtri di sfocatura, l'aggiunta di grana cinematografica o una compressione JPEG intensa (qualità < 60) possono coprire le strutture sottili dei pixel, riducendo l'efficacia del test.
3. Illustrazioni digitali e grafica 3D
Disegni digitali, grafica vettoriale e render 3D (Blender, Unreal Engine) non contengono per loro natura il rumore ottico tipico di una fotocamera. Gli algoritmi statistici potrebbero confondere questa pulizia con una matrice sintetica.
4. Watermark invisibili proprietari (SynthID)
Firme invisibili incorporate direttamente nello spazio latente dei modelli (come SynthID di Google DeepMind) richiedono chiavi di decodifica riservate e non possono essere verificate offline nel browser.
💡 Suggerimento: Utilizza i risultati come un solido supporto analitico. Di fronte a contenuti critici, integra sempre i dati tecnici con il contesto di pubblicazione e l'analisi visiva degli elementi fisici (mani, riflessi, coerenza della luce).
5. Inizia subito
Vuoi esaminare un'immagine?
- Apri il Rilevatore di immagini AI gratuito.
- Trascina un file, incolla dagli appunti o inserisci l'indirizzo di un'immagine online.
- Controlla l'indice di probabilità, la confidenza ed espandi le evidenze per visualizzare tutti i riscontri tecnici.
Riferimenti e ulteriori letture
- 01.ExifReader — Fast JavaScript image metadata parsing librarygithub.com/mattiasw/ExifReader
- 02.
- 03.Content Authenticity Initiative (CAI) — Open source provenance toolscontentauthenticity.org/
- 04.IPTC Photo Metadata Standard & Digital Source Type Vocabularyiptc.org/standards/photo-metadata/
- 05.Canvas API & ImageData — MDN Web Docsdeveloper.mozilla.org/en-US/docs/Web/API/Canvas_API
- 06.Discrete Laplace Operator in Digital Image Processing — Wikipediaen.wikipedia.org/wiki/Discrete_Laplace_operator
- 07.WebAssembly — High-performance client-side runtime standardwebassembly.org/
- 08.Google DeepMind SynthID — Imperceptible generative AI watermarkingdeepmind.google/technologies/synthid/
- 09.Stable Diffusion WebUI by AUTOMATIC1111github.com/AUTOMATIC1111/stable-diffusion-webui
- 10.ComfyUI — Powerful modular node-based Stable Diffusion GUIgithub.com/comfyanonymous/ComfyUI