Midjourney v6、OpenAI DALL-E 3、Stable Diffusion XL、Flux.1、Google Imagenなど、生成AI技術の飛躍的進化により、写真と見分けがつかないリアルな画像が誰でも一瞬で生成できるようになりました。
この進歩は創作の可能性を無限に広げた一方で、フェイクニュースの拡散、ディープフェイク、ストックフォトの汚染、コンテストでの不正、著作権の帰属問題など、深刻な課題を生み出しています。
こうした課題に対し、ImageSizeFinderでは完全にオープンで客観的な 無料AI画像検出器 を開発・公開しました。理由の説明もなくブラックボックスな確率値を有料サブスクリプションで返す従来のツールとは異なり、当ツールはプライバシーを最優先にしたデュアルレイヤー検出アーキテクチャを採用しています。ブラウザ上で直接動作し、判定の根拠となったデータを透明に開示します。
本稿では、その機能特性、判定アルゴリズムの数学的詳細、アーキテクチャ、そして実際の利用における限界について解説します。
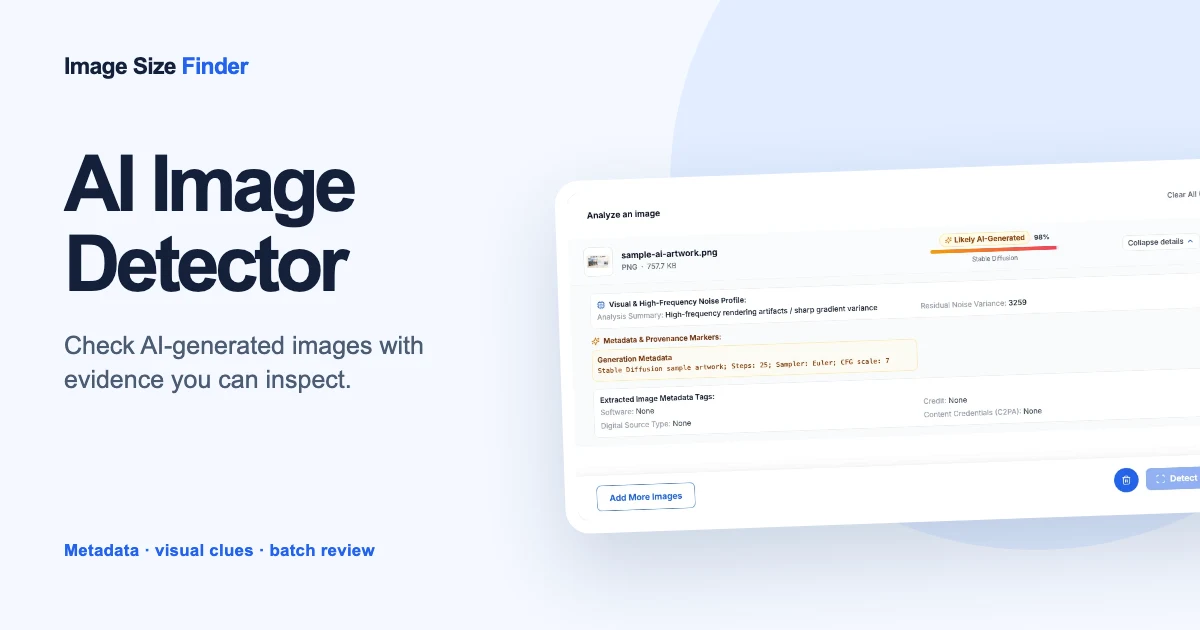 図1:ImageSizeFinderの無料AI画像検出器インターフェース。複数ソース入力、バッチ処理、完全ローカル検証に対応。
1. AI画像検出器の主な機能と特徴
利用の手軽さと、プライバシーや解析深度への高度な要求を両立させるため、以下の機能を備えています:
- 完全無料・利用回数無制限:アカウント登録やAPI課金、不自然な1日のスキャン上限は一切ありません。ブラウザローカル検出は無制限に利用できます。
- クライアント側完結のプライバシー保護(Zero-Upload):メタデータ解析とノイズ数学演算は、WebAssemblyとHTML5 Canvas APIを用いて端末のブラウザ内だけで処理されます。クラウド推論を明示的に選択しない限り、画像が外部サーバーへ送信されることはありません。
- 柔軟で多彩な画像入力手段:
- 単一または複数画像の一括ドラッグ&ドロップ。
- OS標準のファイルダイアログからの選択。
- クリップボード貼り付け:ページ上のどこでも
Ctrl+V(macOSはCmd+V)を押すだけで、コピーしたスクリーンショットを即座に解析。 - 画像URL指定:直リンク(
https://)を貼り付けて、画像をダウンロードすることなく直接検証可能。
- 統合バッチワークスペース:数十枚の画像を一度に読み込み、ステータスを一元管理し、ワンクリックで並列検証を実行。
- 透明性の高い証拠パネル:判定結果を展開すると、ツール識別子(Midjourney、DALL-E 3等)、IPTC来歴情報、プロンプト生成パラメータ、残差ノイズ分散値などの客観的根拠を確認できます。
2. 検出アーキテクチャ:デュアルレイヤーの多層フロー
AI生成画像を単一の指標だけで判定することは困難です。メタデータは再保存で失われやすく、ピクセル特性も圧縮によって変化するためです。
そこで当システムでは、段階的なデュアルレイヤーパイプラインを採用しています:
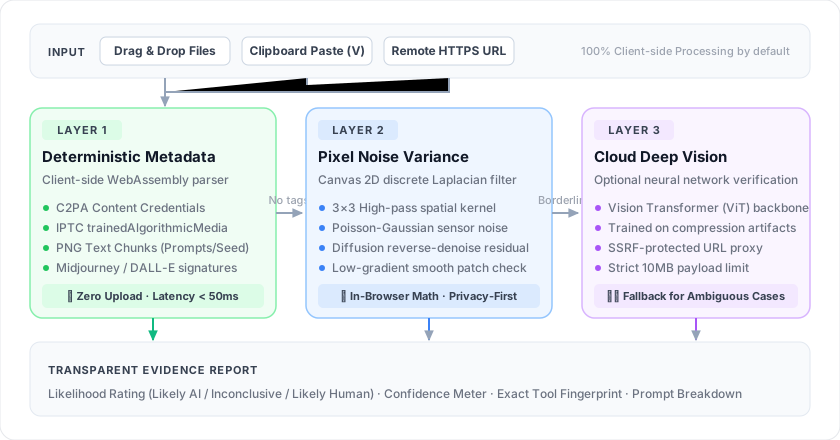 図2:3階層の段階的パイプライン:WebAssemblyによる確定メタデータ高速照合、Canvasピクセル高周波ノイズ畳み込み、任意のクラウドニューラル検証。
3. 実装の詳細:各階層の動作原理
第1層:確定的なメタデータおよびコンテンツ来歴解析
多くの生成AIツールは、画像出力時に標準規格に沿った識別マーカーを埋め込みます。第1層では、ブラウザ側の高速バイナリ解析ライブラリ(ExifReader等)を用いてバイトストリームを高速スキャンします:
- IPTC Digital Source Type(デジタルソースタイプ):
- 国際報道基準規格。AI生成画像には
trainedAlgorithmicMedia(訓練済みアルゴリズム生成)やcompositeSynthetic(合成メディア)が記録されます。 - Google ImagenやAdobe Fireflyなどのサービスが標準で出力します。
- 国際報道基準規格。AI生成画像には
- IPTC CreditおよびSoftwareタグ:
- MidjourneyのWeb出力版は
CreditやSoftwareフィールドにMidjourneyの文字列を埋め込みます。 - DALL-E 3もOpenAI固有の来歴シグネチャを付与します。
- MidjourneyのWeb出力版は
- PNGテキストチャンク(
tEXt,iTXt,zTXt):- Stable Diffusionのエコシステム(Automatic1111、ComfyUI、Forge等)はPNGヘッダー内に生成設定を丸ごと記録します。
- プロンプト、ネガティブプロンプト、シード値、CFGスケール、サンプラー名、LoRA設定などを直接抽出します。
- C2PA(Coalition for Content Provenance and Authenticity):
- Content Authenticity Initiativeが推進するコンテンツ認証規格に則り、JUMBF形式でパッケージされた電子署名コンテナ(
c2paボックス)の有無を照合します。
- Content Authenticity Initiativeが推進するコンテンツ認証規格に則り、JUMBF形式でパッケージされた電子署名コンテナ(
この第1層で明確なマーカーが見つかった場合、重い演算を行わずに即座に 高信頼度(High Confidence) でAI生成と判定します。
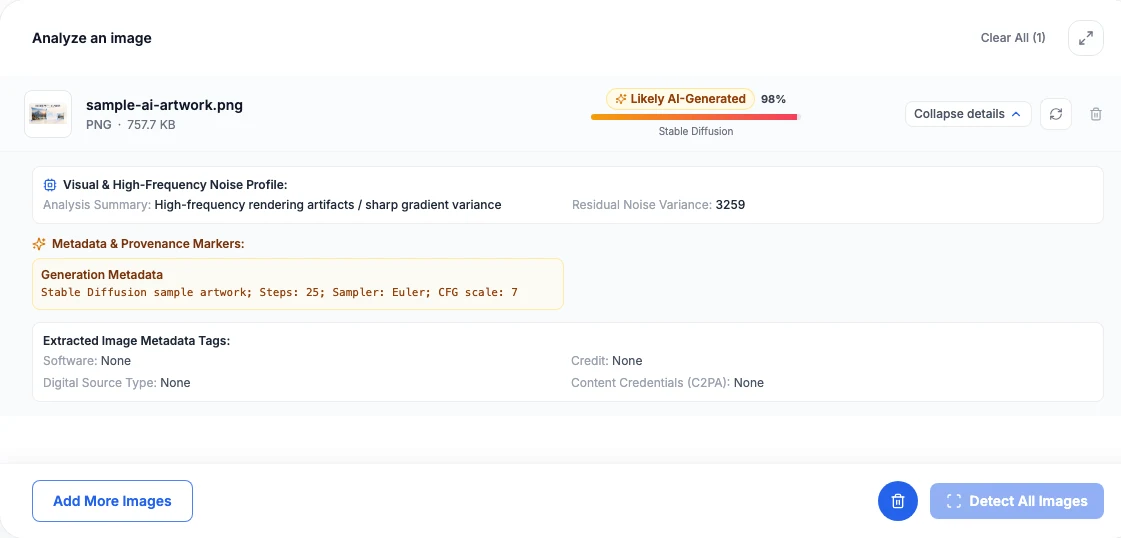 図3:証拠詳細パネルの展開例:抽出された生成パラメータ(ステップ数、サンプラー、CFG)とピクセルノイズ分散メトリクスを表示。
第2層:ブラウザ内ピクセル高周波ノイズ分散解析
画像がJPEGへ再エンコードされたり、外部ツールでメタデータが消去された場合、システムはOffscreenCanvasとHTML5 Canvas APIを利用した空間統計フィルタリングを実行します。
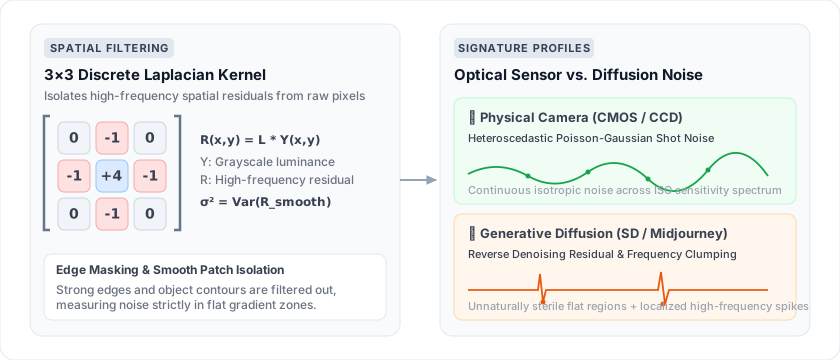 図4:離散3x3ラプラシアン空間高域通過畳み込みと残差R(x, y)の単離。光学センサーノイズと拡散モデルの逆デノイズアーティファクトを対比。
物理的・数学的背景
- 実写カメラセンサー:実在の光学センサー(CMOS/CCD)は光子を受け取る際、量子的なショットノイズや熱雑音を受けます。これらは統計学的に**ポアソン・ガウス分布(Poisson-Gaussian Shot Noise)**に従います。均一な露光面では、自然で等方的なセンサーグレインが存在します。
- 拡散モデル(Diffusion Models):Stable DiffusionやMidjourney等の拡散生成モデルは、初期ガウスノイズから逆デノイズ(Reverse Denoising)を繰り返すことで画像を生成します。この数理アルゴリズムは微小ピクセル空間に特有の自己相関を残し、平坦な領域が不自然に無菌的であったり、テクスチャ境界に特異な周波数集中が生じます。
アルゴリズムの流れ
- 画像を原寸のまま
OffscreenCanvasに描画。 getImageDataを用いてピクセルの輝度値Y(x, y)を抽出。- 3x3の離散ラプラシアン空間フィルタを適用し、高周波残差
R(x, y)を分離:┌ ┐ │ 0 -1 0 │ │ -1 4 -1 │ │ 0 -1 0 │ └ ┘ - コントラストの高いエッジを除外し、平坦領域における残差分散
σ²を算出:σ² = (1/N) · Σ (Rᵢ − R̄)² - この分散値とスペクトル分布を、実写カメラセンサーの基準データベースと照合。
この計算はクライアント端末のJavaScriptで直接実行されるため、1枚あたりわずか50〜150ミリ秒で完了し、ネットワーク転送の遅延も皆無です。
第3層:クラウドディープビジョンエンジン(オプション)
メタデータが存在せず、ローカルのノイズ指標が中間的なグレーゾーンにある場合、サーバー上の深層学習モデルを補助として呼び出すことができます:
- 膨大な実写・生成画像ペアで耐圧縮ロバストネス学習を行ったVision Transformerモデルを搭載。
- 外部URLの解析(
/api/ai-image-detector/fetch-url)では、SSRF対策やMIME制限、10MB上限など堅牢なセキュリティガードを適用。
4. 検出ツールの限界と注意点
いかなるAI検出ツールも100%完璧ではありません。判定結果を評価する際は、以下の実情を念頭に置いてください:
1. SNSやメッセージアプリによるメタデータ削除
Twitter/X、Instagram、LINE、Facebookなどの主要SNSは、画像投稿時にEXIF、IPTC、C2PAを含むすべてのメタデータを強制的に消去し、不可逆圧縮を行います。SNSから保存した画像では、第1層のメタデータは検出できません。
2. 強力な二次編集と不可逆圧縮
ぼかしフィルターの付加、フィルムグレインエフェクトの追加、強いJPEG再圧縮(品質60未満)を行った画像では、微細なピクセルノイズ構造が上書きされ、判定精度が影響を受ける場合があります。
3. デジタルイラスト・3D CG作品
イラスト、ベクターアート、3Dレンダリング(Blender、Unreal Engine)は、物理的な光学センサーノイズを持ちません。そのため平滑度の高さからアルゴリズムが人工的な特徴として検知することがあります。表現媒体の文脈を踏まえてご判断ください。
4. クローズドな潜在空間電子透かし(SynthID等)
拡散モデルの潜在空間(Latent Space)内部に直接埋め込まれた不可視電子透かし(Google DeepMindのSynthIDなど)は専用サーバーと秘密鍵が必要であり、公開ブラウザ環境でオフライン解析することはできません。
💡 推奨事項:AI検出結果は、真偽判断のための客観的な材料や補助的な手がかりとしてご活用ください。重要な判断を下す際は、画像の出所、手指の骨格、文字の不自然さ、光と影の物理的整合性などを総合的に検証することをお勧めします。
5. 今すぐ画像をチェック
お手元の画像を検証してみませんか?
- 無料AI画像検出器 にアクセス。
- 画像をドラッグ&ドロップ、クリップボードから貼り付け、またはURLを入力。
- 判定バッジと信頼度スコアを確認し、証拠パネルを展開して検出されたメタデータやノイズ指標をチェックしてください。
参考文献・公式技術資料
- 01.ExifReader — Fast JavaScript image metadata parsing librarygithub.com/mattiasw/ExifReader
- 02.
- 03.Content Authenticity Initiative (CAI) — Open source provenance toolscontentauthenticity.org/
- 04.IPTC Photo Metadata Standard & Digital Source Type Vocabularyiptc.org/standards/photo-metadata/
- 05.Canvas API & ImageData — MDN Web Docsdeveloper.mozilla.org/en-US/docs/Web/API/Canvas_API
- 06.Discrete Laplace Operator in Digital Image Processing — Wikipediaen.wikipedia.org/wiki/Discrete_Laplace_operator
- 07.WebAssembly — High-performance client-side runtime standardwebassembly.org/
- 08.Google DeepMind SynthID — Imperceptible generative AI watermarkingdeepmind.google/technologies/synthid/
- 09.Stable Diffusion WebUI by AUTOMATIC1111github.com/AUTOMATIC1111/stable-diffusion-webui
- 10.ComfyUI — Powerful modular node-based Stable Diffusion GUIgithub.com/comfyanonymous/ComfyUI