Dynamiczny rozwój generatywnej sztucznej inteligencji gruntownie przekształcił przestrzeń mediów wizualnych. Zaawansowane modele, takie jak Midjourney v6, OpenAI DALL-E 3, Stable Diffusion XL, Flux.1 czy Google Imagen, potrafią w ułamku sekundy wygenerować fotorealistyczne portrety, krajobrazy i fotoreportaże.
Ten przełom otwiera ogromne możliwości artystyczne, ale rodzi też poważne wyzwania: manipulacje deepfake, dezinformację, zanieczyszczenie banków zdjęć i spory prawne dotyczące praw autorskich.
W odpowiedzi na te problemy stworzyliśmy Darmowy detektor obrazów AI w ImageSizeFinder. W przeciwieństwie do płatnych rozwiązań, które pobierają opłaty za niepoparte dowodami wartości procentowe, nasze narzędzie opiera się na dwuwarstwowej architekturze weryfikacji chroniącej prywatność. Wykonuje ono deterministyczne sprawdzenia bezpośrednio w Twojej przeglądarce i udostępnia przejrzyste dowody techniczne.
W tym przewodniku opisujemy funkcje, zasady działania, aparat matematyczny i praktyczne ograniczenia detektora.
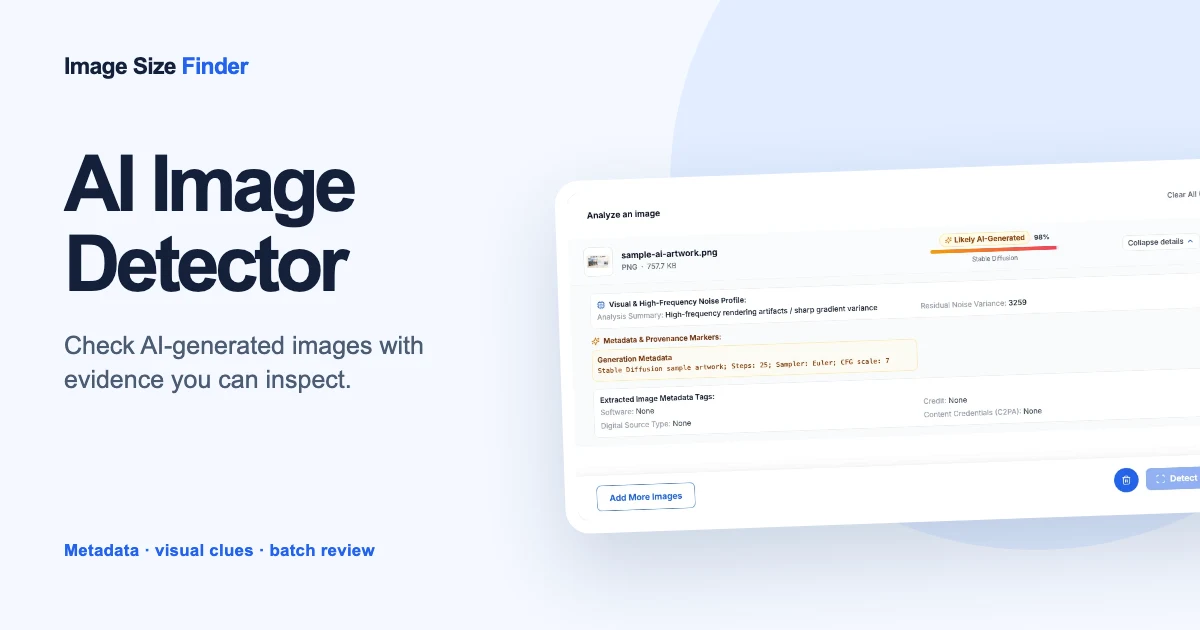 Rysunek 1: Interfejs darmowego detektora obrazów AI ImageSizeFinder z obsługą wielu źródeł, przetwarzaniem wsadowym i lokalną weryfikacją bez wysyłania plików.
1. Główne możliwości detektora obrazów AI
Detektor zaprojektowano tak, by łączył szybkość, prywatność i rzetelność analizy:
- 100% darmowy i bez limitów: Bez konieczności rejestracji, bez kart płatniczych i bez sztucznych limitów dziennych dla lokalnych analiz w przeglądarce.
- Prywatność po stronie klienta (Zero-Upload): Odczyt metadanych oraz matematyczne obliczenia wariancji szumu odbywają się bezpośrednio w Twojej przeglądarce dzięki technologii WebAssembly i HTML5 Canvas API. Twoje zdjęcia nie trafiają na serwery zewnętrzne, chyba że zażądasz analizy chmurowej.
- Elastyczne sposoby wprowadzania obrazów:
- Przeciąganie i upuszczanie pojedynczych lub wielu plików jednocześnie.
- Wybór plików przez systemowe okno dialogowe.
- Wklejanie ze schowka: naciśnij
Ctrl+V(lubCmd+Vna macOS) w dowolnym miejscu strony, by natychmiast sprawdzić zrzut ekranu. - Bezpośredni adres URL: wklej link
https://, aby zbadać grafikę z sieci bez wcześniejszego pobierania.
- Wsadowy obszar roboczy: Wgrywaj dziesiątki grafik, kontroluj ich statusy w uporządkowanym widoku i uruchamiaj weryfikację jednym kliknięciem.
- Przejrzysty panel dowodowy: Rozwiń dowolny zbadany plik, aby sprawdzić konkretne powody oceny: sygnatury oprogramowania, znaczniki IPTC, parametry promptu i wariancję szumów resztkowych.
2. Architektura detekcji: Dwuwarstwowy schemat analizy
Wiarygodna identyfikacja obrazów wygenerowanych przez AI jest trudna, ponieważ pojedynczy sygnał bywa zawodny. Metadane można usunąć, a ponowna kompresja zniekształca strukturę pikseli.
Nasz system stosuje hierarchiczny schemat dwuwarstwowy:
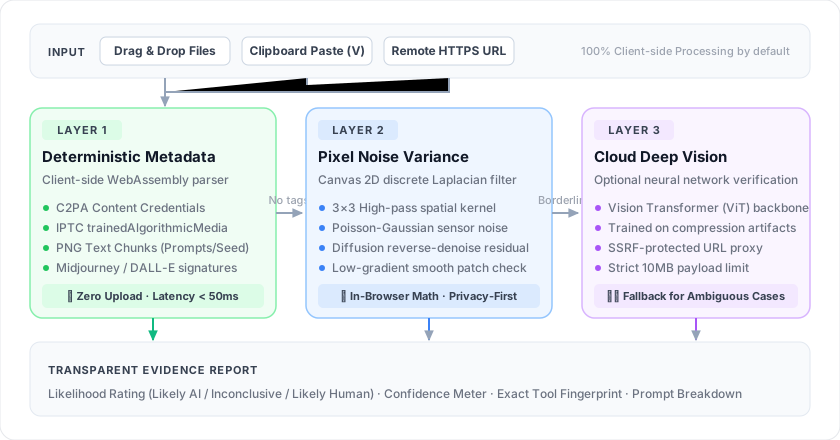 Rysunek 2: Progresywna architektura trójpoziomowa: deterministyczna weryfikacja metadanych w WebAssembly, konwolucja szumów Canvas i opcjonalna weryfikacja neuronowa w chmurze.
3. Szczegóły techniczne: Zasada działania poszczególnych warstw
Warstwa 1: Deterministyczne metadane i weryfikacja pochodzenia
Wiele generatorów sztucznej inteligencji zapisuje maszynowo czytelne znaczniki w plikach wyjściowych. Pierwsza warstwa wykorzystuje wyspecjalizowane biblioteki binarne w przeglądarce (takie jak ExifReader):
- IPTC Digital Source Type:
- Międzynarodowy standard metadanych, w którym grafiki AI oznaczane są jako
trainedAlgorithmicMedialubcompositeSynthetic. - Google Imagen i Adobe Firefly standardowo uzupełniają to pole.
- Międzynarodowy standard metadanych, w którym grafiki AI oznaczane są jako
- Znaczniki IPTC Credit i Software:
- Midjourney często umieszcza tekst
Midjourneyw poluCreditlubSoftware. - DALL-E 3 zawiera charakterystyczne sygnatury pochodzące od OpenAI.
- Midjourney często umieszcza tekst
- Bloki tekstowe PNG (
tEXt,iTXt,zTXt):- Systemy z rodziny Stable Diffusion (Automatic1111, ComfyUI, Forge) zapisują pełną konfigurację w nagłówku PNG.
- Odczytujemy prompty pozytywne i negatywne, ziarno (seed), CFG scale, sampler oraz wagi modeli LoRA.
- Poświadczenia C2PA Content Credentials:
- Zgodnie z wytycznymi Content Authenticity Initiative wyszukujemy kontenery JUMBF zawierające cyfrowo podpisane certyfikaty pochodzenia (
c2pa).
- Zgodnie z wytycznymi Content Authenticity Initiative wyszukujemy kontenery JUMBF zawierające cyfrowo podpisane certyfikaty pochodzenia (
W przypadku znalezienia jednoznacznych metadanych system przyznaje status Wysokiej Pewności (High Confidence) bez konieczności angażowania mocy obliczeniowej.
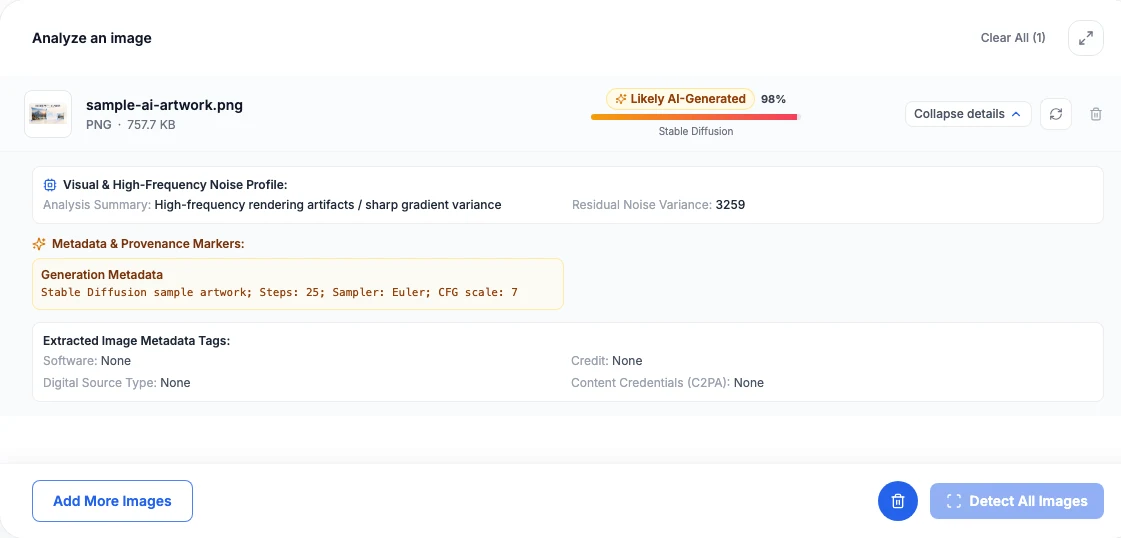 Rysunek 3: Widok panelu dowodowego ze szczegółami wykrytych parametrów generowania (kroki, sampler, CFG) oraz metrykami wariancji szumów.
Warstwa 2: Analiza wariancji szumu pikseli w przeglądarce
Gdy obraz nie zawiera metadanych (na przykład po ponownym zapisaniu w formacie JPEG), przeglądarka uruchamia analizę przestrzenną w tle przy użyciu OffscreenCanvas oraz HTML5 Canvas API.
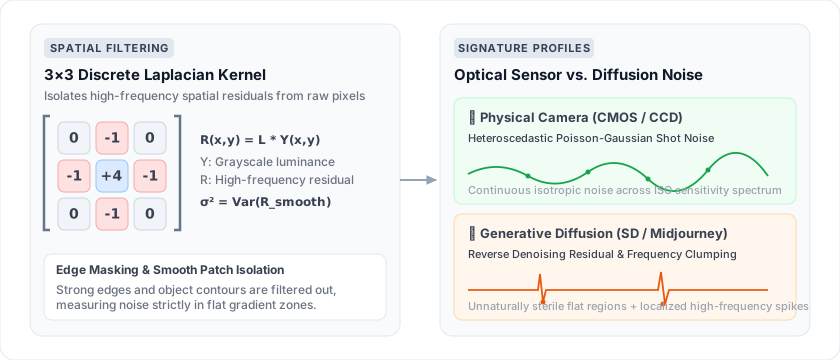 Rysunek 4: Dyskretna konwolucja laplasjanowa 3x3 izolująca resztkowy szum wysokoczęstotliwościowy R(x, y), porównująca fizyczny sensor optyczny z artefaktami modeli dyfuzyjnych.
Podłoże fizyczne i matematyczne
- Prawdziwe matryce aparatów: Fizyczne matryce optyczne (CMOS/CCD) rejestrują fotony obarczone szumem śrutowym i termicznym, podlegające rozkładowi Poissona-Gaussa. Na jednolitych powierzchniach szum sensora wykazuje naturalne właściwości izotropowe.
- Generatywne modele dyfuzyjne: Modele takie jak Stable Diffusion czy Midjourney tworzą obrazy poprzez stopniowe usuwanie szumu z początkowego szumu gaussowskiego. Pozostawia to charakterystyczne korelacje przestrzenne: gładkie obszary bywają nienaturalnie jednolite, podczas gdy partie fakturowane wykazują nietypowe skupiska energii.
Etapy algorytmu
- Rysowanie grafiki w skali 1:1 na niewidocznym
OffscreenCanvas. - Pobranie macierzy luminancji
Y(x, y)przy użyciugetImageData. - Zastosowanie dyskretnego filtra laplasjanowego 3x3 w celu wyodrębnienia residuum wysokoczęstotliwościowego
R(x, y):┌ ┐ │ 0 -1 0 │ │ -1 4 -1 │ │ 0 -1 0 │ └ ┘ - Wykluczenie kontrastowych krawędzi i obliczenie wariancji resztkowej
σ²na powierzchniach gładkich:σ² = (1/N) · Σ (Rᵢ − R̄)² - Zestawienie wariancji z bazą profili referencyjnych rzeczywistych matryc fotograficznych.
Ponieważ operacje te wykonuje kod JavaScript bezpośrednio na Twoim komputerze, analiza trwa zaledwie 50–150 milisekund na obraz, bez żadnych opóźnień sieciowych.
Warstwa 3: Głęboki model widzenia w chmurze (Opcjonalny)
Gdy brakuje metadanych, a wskaźniki szumu znajdują się na granicy niepewności, użytkownik może skorzystać z analizy modelu neuronowego w chmurze:
- Oparty na architekturze Vision Transformer wytrenowanej na milionach par zdjęć prawdziwych i syntetycznych.
- Bezpieczna obsługa zewnętrznych linków URL (
/api/ai-image-detector/fetch-url) z zabezpieczeniami przed atakami SSRF i limitem pliku do 10 MB.
4. Ograniczenia techniczne i wskazówki praktyczne
Żaden detektor sztucznej inteligencji nie jest w 100% nieomylny. Oceniając wyniki, weź pod uwagę następujące kwestie:
1. Usuwanie danych przez serwisy społecznościowe
Portale takie jak WhatsApp, Instagram czy X ponownie kompresują pliki i bezwzględnie usuwają wszystkie metadane EXIF, IPTC i C2PA. Obrazy pobrane z social mediów nie wykażą śladów w Warstwie 1.
2. Silna edycja i kompresja stratna
Nałożenie filtrów rozmycia, efektu ziarna filmowego lub silna kompresja JPEG (jakość < 60) niszczą subtelną strukturę szumu pikseli, co może obniżyć pewność diagnozy.
3. Grafika cyfrowa i rendering 3D
Ilustracje, grafika wektorowa oraz rendery 3D (Blender, Unreal Engine) nie posiadają szumu matrycy aparatu. Narzędzia statystyczne mogą zinterpretować tę gładkość jako cechę syntetyczną. Zawsze analizuj kontekst artystyczny.
4. Niejawne znaki wodne w przestrzeni ukrytej (SynthID)
Niewidoczne znaki wodne zakodowane bezpośrednio w przestrzeni ukrytej modeli (np. SynthID od Google DeepMind) wymagają prywatnych kluczy serwerowych i nie mogą być odczytane offline w standardowej przeglądarce.
💡 Rekomendacja: Traktuj wyniki detektora jako wartościowe wskazówki pomocnicze. W newralgicznych kwestiach zawsze łącz ocenę algorytmiczną z analizą kontekstu publikacji i logicznej spójności fizycznej (dłonie, cienie, odbicia światła).
5. Sprawdź swój pierwszy obraz
Chcesz zweryfikować autentyczność grafiki?
- Przejdź do Darmowego detektora obrazów AI.
- Przeciągnij plik, wklej ze schowka lub podaj adres URL.
- Sprawdź wynik prawdopodobieństwa i rozwiń panel dowodowy, aby przejrzeć szczegółowe wskaźniki techniczne.
Materiały źródłowe i literatura
- 01.ExifReader — Fast JavaScript image metadata parsing librarygithub.com/mattiasw/ExifReader
- 02.
- 03.Content Authenticity Initiative (CAI) — Open source provenance toolscontentauthenticity.org/
- 04.IPTC Photo Metadata Standard & Digital Source Type Vocabularyiptc.org/standards/photo-metadata/
- 05.Canvas API & ImageData — MDN Web Docsdeveloper.mozilla.org/en-US/docs/Web/API/Canvas_API
- 06.Discrete Laplace Operator in Digital Image Processing — Wikipediaen.wikipedia.org/wiki/Discrete_Laplace_operator
- 07.WebAssembly — High-performance client-side runtime standardwebassembly.org/
- 08.Google DeepMind SynthID — Imperceptible generative AI watermarkingdeepmind.google/technologies/synthid/
- 09.Stable Diffusion WebUI by AUTOMATIC1111github.com/AUTOMATIC1111/stable-diffusion-webui
- 10.ComfyUI — Powerful modular node-based Stable Diffusion GUIgithub.com/comfyanonymous/ComfyUI