隨著 Midjourney v6、OpenAI DALL-E 3、Stable Diffusion XL、Flux.1 以及各類商業生成式 AI 技術的飛速演進,AI 生成圖片的逼真程度已達到肉眼難以辨別的地步。從人像攝影、新聞紀實到風景插畫,合成媒體在帶來無限創作便利的同時,也帶來了假訊息傳播、版權歸屬紛爭、攝影競賽造假等諸多現實挑戰。
目前市面上的 AI 檢測工具往往存在**費用高昂、必須上傳原圖產生隱私外洩風險、檢測機制如同黑盒子(僅給出一個缺乏依據的百分比數值)**等痛點。
為此,ImageSizeFinder 推出了全新的 免費 AI 圖片檢測器。它採用隱私優先、瀏覽器本機為主的雙層檢測架構,不僅分析速度極快、完全免費,而且會詳細展開檢測到的元數據標記、演算法佐證與置信度指標,讓使用者能清楚看見結論背後的客觀依據。
本文將深入介紹該檢測器的核心功能特性、架構實現原理、演算法細節以及實際應用中的邊界與注意事項。
 圖 1:ImageSizeFinder 免費 AI 圖片檢測器全景介面,支援多來源載入、批次管理與本機端透明證據鏈。
一、核心功能特性概覽
為了兼顧一般使用者的操作便捷性與專業創作者對隱私與深度的要求,檢測器設計了以下關鍵特性:
- 完全免費且無使用次數上限: 無需註冊登入、無需綁定信用卡、沒有人工設定的每日掃描額度,瀏覽器本機檢測完全開放且無限制。
- 本機端隱私保護(Zero-Upload): 核心元數據解析與高頻雜訊數學分析完全透過瀏覽器端的 WebAssembly 與 HTML5 Canvas API 在您的本機裝置上運算,圖片絕不上傳至遠端伺服器。
- 多元且便捷的輸入管道:
- 多圖拖曳:單張或一次選取數十張圖片拖放至檢測區;
- 本機檔案選擇:點擊按鈕呼叫系統檔案管理器;
- 剪貼簿直接貼上:在頁面任意位置按下
Ctrl+V(macOS 為Cmd+V)即可快速載入截圖或複製的圖片進行分析; - 圖片網址直連:貼上外部
https://直連網址,透過安全代理直接拉取檢測,免去先下載再上傳的繁瑣步驟。
- 統一批次處理工作區: 支援批次管理多張圖片,清單中清晰展示檢測進度、縮圖、評分結果,並提供「一鍵全部檢測」與批次清除功能。
- 透明證據鏈與參數溯源: 展開任意已檢測圖片,可直觀查看生成工具標記(如 Midjourney、DALL-E 3)、IPTC 數位來源標籤、Stable Diffusion 原始提示詞與生成參數,以及像素殘差雜訊方差指標。
二、系統檢測架構:雙層漸進式工作流程
由於單項特徵很容易因二次轉碼或人為後製而被抹除,單一維度的檢測工具極易失效。因此,我們設計了漸進式多維度檢測架構:
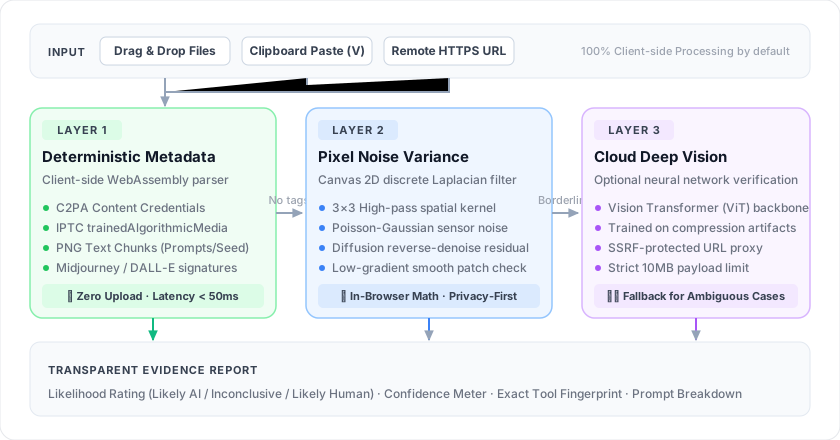 圖 2:三層漸進式流水線架構:端側 WebAssembly 確定性元數據快速篩檢、Canvas 像素高頻殘差雜訊卷積運算與雲端輔助推論。
三、底層實現原理與演算法細節
1. 第一層:確定性元數據與版權溯源解析
許多主流 AI 生成工具在匯出圖片時,都會遵循產業標準或軟體規範寫入機器可讀標記。第一層利用瀏覽器端高效能元數據解析庫(ExifReader)對二進位資料流進行快速掃描:
- IPTC Digital Source Type(數位來源類型):
國際通用的新聞元數據標準,AI 生成圖片常被標註為
trainedAlgorithmicMedia(演算法模型訓練生成)或compositeSynthetic(合成媒體)。Google Imagen、Adobe Firefly 等皆會主動寫入此欄位。 - IPTC Credit 與 Software(版權與軟體標籤):
Midjourney 網頁匯出版本通常會在
Credit或Software欄位直接寫入Midjourney字樣;DALL-E 3 亦具備專屬的供應商描述資訊。 - PNG 文本區塊(tEXt / iTXt / zTXt):
Stable Diffusion 生態系(Automatic1111 WebUI、ComfyUI、Forge 等)預設會在 PNG 的文字區塊中寫入完整的生成參數。我們透過底層二進位掃描,可直接萃取出:
- 正向提示詞(Prompt)與負向提示詞(Negative Prompt)
- 取樣步數(Steps)、取樣器(Sampler)
- 隨機種子(Seed)、CFG Scale
- 基礎模型與 LoRA 權重名稱
- C2PA 內容憑據(Content Credentials):
針對數位內容真實性聯盟規範(Content Authenticity Initiative),掃描檔案中是否包含以 JUMBF(JPEG Universal Metadata Box Format)格式封裝的數位簽章容器(
c2pabox 標記)。
若本層檢測到確鑿證據,系統會直接判定為 高置信度(High Confidence),無需耗費後續運算資源。
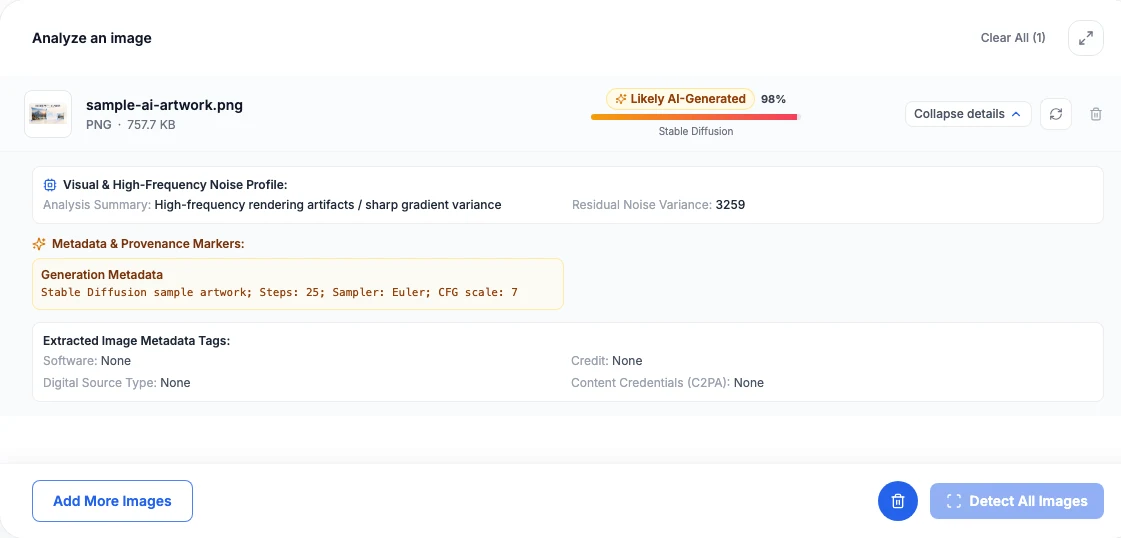 圖 3:證據詳情面板展開:完整呈現檢測出的 Stable Diffusion 模型生成提示詞、取樣步數、CFG Scale 及殘差雜訊方差等透明客觀線索。
2. 第二層:本機端像素高頻雜訊方差分析(Pixel Noise Analysis)
當圖片被另存為 JPEG 或由第三方軟體清除了元數據後,系統將自動進入像素級統計分析階段,借助瀏覽器 OffscreenCanvas 與 HTML5 Canvas API 進行即時影像空間濾波分析。
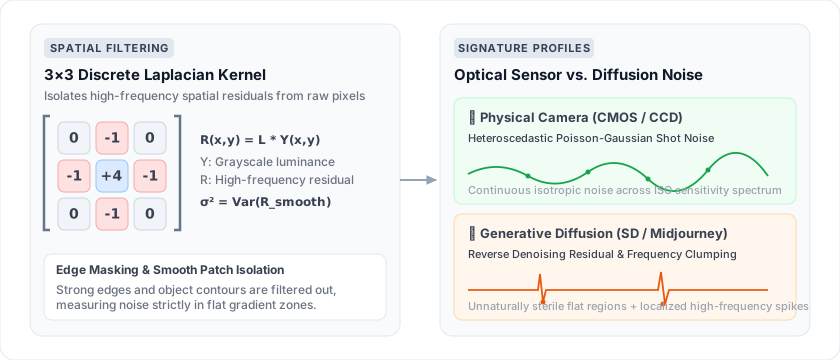 圖 4:3x3 離散拉普拉斯空間高通卷積核與平滑區方差計算,有效對比物理光學感光元件散粒雜訊與擴散模型反向去噪殘差。
物理與數學原理
- 真實相機感光元件:真實相機鏡頭與光學感光元件(CMOS/CCD)在捕捉光子時,受到光子散粒雜訊與感光元件熱雜訊影響,呈現出物理意義上的卜瓦松-高斯分佈(Poisson-Gaussian Shot Noise)。在均勻受光的高光與陰影過渡區,雜訊分佈具備高度各向同性的統計規律。
- 擴散生成模型(Diffusion Models):以 Stable Diffusion、Midjourney、Flux 為代表的擴散模型,其生成機制是基於高斯雜訊圖逐步執行「反向去噪(Reverse Denoising)」。這種演算法在微觀像素級會遺留細微的高頻空間自相關特徵,且在純色平坦區域往往顯得過於純淨,在複雜紋理區域又會出現異常的高頻能量聚集。
本機演算法步驟
- 使用未縮放的 OffscreenCanvas 讀取影像的無損像素陣列。
- 提取像素灰階亮度矩陣
Y(x, y)。 - 套用 3x3 離散拉普拉斯高通卷積核(Laplacian Kernel) 過濾掉低頻構圖與色彩,分離出高頻殘差圖
R(x, y):┌ ┐ │ 0 -1 0 │ │ -1 4 -1 │ │ 0 -1 0 │ └ ┘ - 排除強邊緣與高對比輪廓,在低梯度的平滑區域計算殘差方差
σ²:σ² = (1/N) · Σ (Rᵢ − R̄)² - 結合方差數值與頻域能量分佈,與真實相機感光元件基準數據庫進行比對推論。
由於該演算法完全在本機透過純 JavaScript / TypedArray 運算,單張圖片處理耗時僅需 50–150 毫秒,且零網路延遲。
3. 第三層:雲端深度視覺模型推論(可選輔助)
當本地元數據缺失且本地雜訊指標處於臨界模糊區間時,使用者可觸發選用的雲端深度推論引擎:
- 採用輕量化卷積 / 視覺 Transformer(ViT)架構,在海量真實照片與生成樣本對上進行過抗壓縮強健性訓練。
- 針對外部圖片網址,伺服器提供具備安全防護(SSRF 攻擊阻擋、MIME 類型白名單、10 MB 檔案大小上限)的代理載入通道。
四、檢測局限性與使用注意事項
客觀了解技術邊界對於合理使用工具至關重要。在使用 AI 檢測器時建議留意以下重點:
1. 社群平台與通訊軟體的元數據抹除
LINE、Facebook、Instagram、Twitter/X 等社群媒體在圖片上傳時,出於使用者隱私保護與頻寬節省,會自動強制清除所有 EXIF、IPTC 和 C2PA 憑據並進行有損壓縮。因此,直接從社群媒體下載儲存的圖片,元數據層面大多無法找到原始工具的數位軌跡。
2. 重度二次編輯與壓縮偽影
若 AI 生成的圖片經過了多次高強度有損壓縮(JPEG Quality < 60)、套用了厚重的底片雜訊濾鏡(Film Grain)或被重複螢幕截圖,原有的高頻殘差特徵結構會被干擾雜訊覆蓋,進而影響判定準確度。
3. 數位插畫、3D 渲染與手繪作品
3D 渲染圖(Blender / Unreal Engine)、向量插畫或扁平電繪由於缺少實體相機感光元件的光學雜訊,其平滑度極高,可能容易被演算法識別為帶有 AI 生成特徵。建議在分析插畫創作時,結合畫面語意與創作者背景綜合研判。
4. 隱形潛在浮水印(如 Google SynthID)
部分科技企業在擴散模型潛在空間(Latent Space)直接嵌入的抗裁剪隱形浮水印(例如 Google DeepMind SynthID),需要專屬私鑰與伺服器介面才能解密讀取,無法在開放的瀏覽器端直接離線還原。
💡 客觀建議:AI 檢測結果應當作為輔助判斷的重要線索與參考證據,而非唯一的法律鑑識標準。遇到關鍵內容時,建議結合上下文脈絡、畫面物理合理性(如手部骨骼結構、文字清晰度、陰影光影)以及原始發布管道進行多維度交叉驗證。
五、立即體驗
立即開始檢驗您的第一張圖片:
- 前往 ImageSizeFinder 免費 AI 圖片檢測器。
- 拖放圖片檔案、從剪貼簿貼上截圖,或輸入直連網址。
- 查看即時呈現的 AI 生成機率徽章、置信度評級,並展開證據面板檢閱底層元數據與雜訊指標。
透過端側隱私防護、透明證據展示與完全零收費門檻,我們希望能讓每個人都能輕鬆便捷地檢驗數位圖像的真實性。
參考文獻與權威資料
- 01.ExifReader — Fast JavaScript image metadata parsing librarygithub.com/mattiasw/ExifReader
- 02.
- 03.Content Authenticity Initiative (CAI) — Open source provenance toolscontentauthenticity.org/
- 04.IPTC Photo Metadata Standard & Digital Source Type Vocabularyiptc.org/standards/photo-metadata/
- 05.Canvas API & ImageData — MDN Web Docsdeveloper.mozilla.org/en-US/docs/Web/API/Canvas_API
- 06.Discrete Laplace Operator in Digital Image Processing — Wikipediaen.wikipedia.org/wiki/Discrete_Laplace_operator
- 07.WebAssembly — High-performance client-side runtime standardwebassembly.org/
- 08.Google DeepMind SynthID — Imperceptible generative AI watermarkingdeepmind.google/technologies/synthid/
- 09.Stable Diffusion WebUI by AUTOMATIC1111github.com/AUTOMATIC1111/stable-diffusion-webui
- 10.ComfyUI — Powerful modular node-based Stable Diffusion GUIgithub.com/comfyanonymous/ComfyUI