Generativ kunstig intelligens har revolutioneret produktionen af visuelle medier. Moderne systemer som Midjourney v6, OpenAI DALL-E 3, Stable Diffusion XL, Flux.1 og Google Imagen kan på sekunder frembringe naturtro portrætter, landskaber og fotoreportager.
Denne kreative frihed medfører dog også væsentlige udfordringer: spredning af desinformation, deepfakes, forurening af billedarkiver og uklarhed omkring ophavsret.
For at tilbyde en åben og pålidelig løsning har ImageSizeFinder skabt den Gratis AI-billedetektor. Modsat lukkede tjenester, der kræver abonnement for et udokumenteret procenttal, bygger vores værktøj på en privatlivsorienteret dobbeltlagsarkitektur. Analysen udføres deterministisk direkte i din browser og fremlægger gennemsigtige, verificerbare beviser.
I denne guide forklarer vi nøglefunktionerne, systemarkitekturen, de matematiske metoder og de praktiske grænser for analysen.
 Figur 1: Brugerfladen i ImageSizeFinders gratis AI-billedetektor med understøttelse af mange kilder, batchbehandling og lokal privatlivskontrol.
1. Nøglefunktioner i AI-billedetektoren
Værktøjet er udformet til at forene hurtighed, databeskyttelse og analytisk præcision:
- 100 % gratis og ubegrænset: Ingen oprettelse af brugerkonto, intet abonnement og ingen kunstige daglige kvoter for lokale browseranalyser.
- Privatliv på klientsiden (Zero-Upload): Udlæsning af metadata og beregning af pixelstøjvarians kører fuldstændigt i din browser via WebAssembly og HTML5 Canvas API. Dine billeder sendes aldrig til eksterne servere, medmindre du udtrykkeligt anmoder om dybere cloud-scanning.
- Fleksible inputmuligheder:
- Træk og slip enkelte eller mange filer på én gang.
- Vælg filer via computerens normale stifinder.
- Indsæt direkte fra udklipsholderen: Tryk
Ctrl+V(ellerCmd+Vpå macOS) et vilkårligt sted på siden for lynhurtigt at undersøge et skærmbillede. - Direkte billed-URL: Indsæt et
https://-link for at analysere webbilleder uden at skulle gemme dem lokalt først.
- Integreret batch-arbejdsområde: Tilføj snesevis af billeder ad gangen, overskue statusser på en samlet liste og igangsæt scanningen med et enkelt klik.
- Gennemsigtigt bevispanel: Fold et vilkårligt analyseret billede ud for at se den præcise begrundelse: softwarefingeraftryk, IPTC-oprindelsesmærker, promptparametre og residual støjvarians.
2. Detekteringsarkitektur: Den trinvise to-lags pipeline
Det er en udfordrende opgave at identificere AI-skabte billeder sikkert, fordi intet enkelt signal er ufejlbarligt. Metadata kan fjernes, og efterfølgende kompression ændrer på billedernes mikrostruktur.
Vores system benytter derfor en hierarkisk dobbeltlagspipeline:
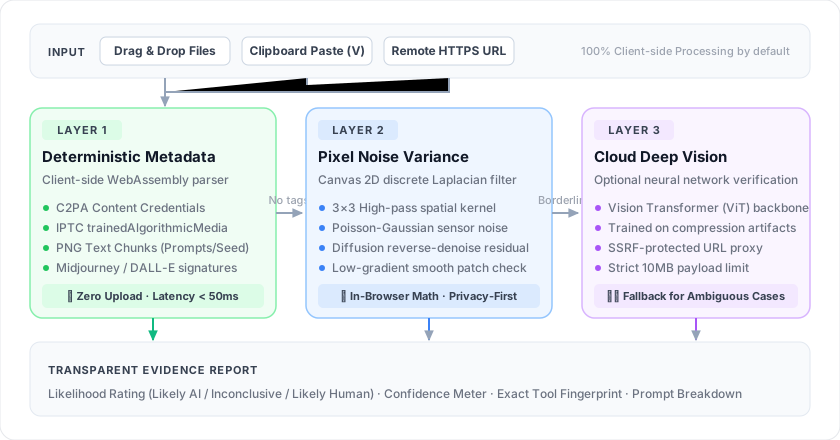 Figur 2: Progressiv tretrinsarkitektur: deterministisk metadatatjek via WebAssembly, højfrekvent Canvas-støjkonvolution og valgfri neural cloud-verifikation.
3. Tekniske detaljer: Sådan fungerer lagene
Lag 1: Deterministiske metadata og oprindelsessporing
Mange generative AI-værktøjer indlejrer maskinlæsbare markører, når billedet gemmes. Første lag benytter binære klientbiblioteker (f.eks. ExifReader) til hurtigt at gennemsøge billedstrømmen:
- IPTC Digital Source Type:
- International mediestandard, hvor AI-genererede billeder markeres som
trainedAlgorithmicMediaellercompositeSynthetic. - Værktøjer som Google Imagen og Adobe Firefly udfylder systematisk dette felt.
- International mediestandard, hvor AI-genererede billeder markeres som
- IPTC Credit- og Software-tags:
- Midjourney gemmer ofte teksten
Midjourneyi feltetCreditellerSoftware. - DALL-E 3 indeholder specifikke signaturer, der peger direkte på OpenAI.
- Midjourney gemmer ofte teksten
- PNG-tekstblokke (
tEXt,iTXt,zTXt):- Software i Stable Diffusion-miljøet (Automatic1111, ComfyUI, Forge) gemmer alle parametre i PNG-headeren.
- Vi udtrækker positive og negative prompts, seed, CFG-skala, sampler og LoRA-modelnavne.
- C2PA Content Credentials:
- I tråd med Content Authenticity Initiative undersøger vi datastrømmen for JUMBF-containere med digitale ægthedscertifikater (
c2pa).
- I tråd med Content Authenticity Initiative undersøger vi datastrømmen for JUMBF-containere med digitale ægthedscertifikater (
Finder vi klare deterministiske beviser her, vurderer systemet straks billedet med Høj Konfidens (High Confidence) uden unødige beregninger.
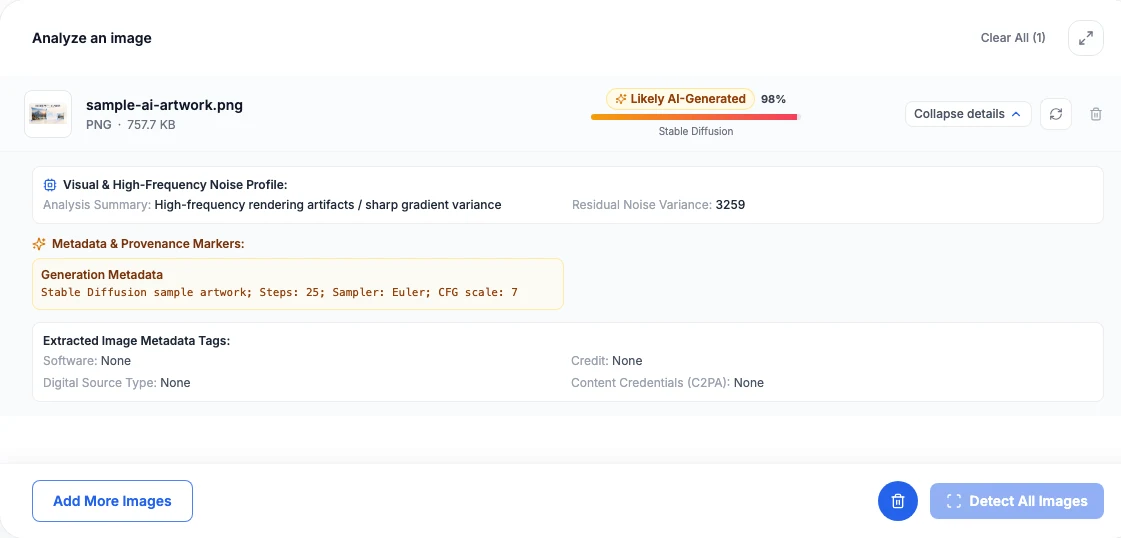 Figur 3: Udfoldet bevispanel der viser de fundne genereringsparametre (trin, sampler, CFG) og værdier for residual støjvarians.
Lag 2: Analyse af pixelstøjvarians i browseren
Hvis et billede mangler metadata (f.eks. efter en JPEG-konvertering eller bevidst rensning), igangsætter browseren en rumlig statistisk analyse via OffscreenCanvas og HTML5 Canvas API.
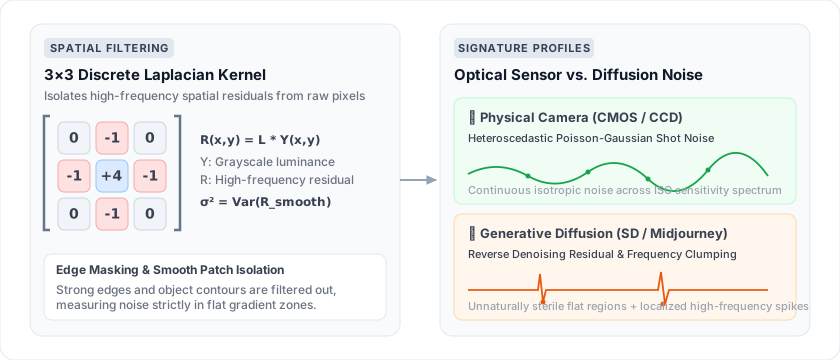 Figur 4: Diskret 3x3 Laplace-konvolutionsfilter der isolerer højfrekvent residual støj R(x, y) og sammenligner optiske kamerasensorer med diffusionsmodeller.
Fysiske og matematiske principper
- Reelle kamerasensorer: Fysiske optiske sensorer (CMOS/CCD) fanger fotoner, der er underlagt foton-skudstøj og termiske udsving i en Poisson-Gauss-fordeling. På ensartede overflader har sensorstøjen en naturlig, isotrop struktur.
- Generative diffusionsmodeller: Modeller som Stable Diffusion eller Midjourney opbygger billeder ved trinvist at fjerne støj fra et indledende Gaussisk støjfelt. Dette efterlader mikroskopiske rumlige autokorrelationer: plane flader fremstår ofte unaturligt jævne, mens teksturzoner udviser atypiske frekvensspidser.
Algoritmens faser
- Billedet tegnes i fuld størrelse på et
OffscreenCanvas. - Lysstyrkeværdierne
Y(x, y)udtrækkes medgetImageData. - Et diskret 3x3 Laplace-filter adskiller den højfrekvente reststøj
R(x, y):┌ ┐ │ 0 -1 0 │ │ -1 4 -1 │ │ 0 -1 0 │ └ ┘ - Kontrastrige kanter sorteres fra for at beregne restvariansen
σ²i jævne områder:σ² = (1/N) · Σ (Rᵢ − R̄)² - Den fundne varians sammenholdes med en referencedatabase over ægte kamerasensorer.
Da beregningen foregår i JavaScript lokalt på din enhed, tager den blot 50-150 millisekunder pr. billede, helt uden netværksforsinkelse.
Lag 3: Dyb computervisionsmodel i skyen (Valgfri)
Hvis metadata mangler og støjværdierne befinder sig i en gråzone, kan brugeren tilkalde bistand fra en avanceret neural model i skyen:
- Bygget på Vision Transformer-arkitektur trænet på millioner af par af ægte og syntetiske billeder.
- Sikrer kontrol af eksterne billed-URL'er (
/api/ai-image-detector/fetch-url) med SSRF-forsvar og en filstørrelsesgrænse på 10 MB.
4. Begrænsninger og gode råd ved brug
Intet AI-detekteringsværktøj er 100 % ufejlbarligt. Vær opmærksom på følgende praktiske forhold:
1. Fjernelse af metadata på sociale medier
Tjenester som WhatsApp, Instagram og X genkomprimerer uploads og sletter konsekvent alle EXIF-, IPTC- og C2PA-metadata. Billeder hentet herfra vil derfor ikke give udslag i Lag 1.
2. Efterbehandling og hård kompression
Tilføjelse af sløring, kunstigt filmkorn eller kraftig JPEG-kompression (kvalitet < 60) forstyrrer pixelstøjens mønstre og kan reducere præcisionen.
3. Digital illustration og 3D-grafik
Vektortegninger, digitale malerier og 3D-gengivelser (Blender, Unreal Engine) mangler af natur sensorstøj fra et fysisk kamera. Algoritmerne kan tolke denne renhed som et syntetisk tegn. Vurder altid billedets kunstneriske genre.
4. Proprietære usynlige vandmærker (SynthID)
Vandmærker indlejret i modellernes latente rum (f.eks. Google DeepMinds SynthID) kræver private dekrypteringsnøgler og kan ikke udlæses offline i en browser.
💡 Råd: Brug analyseresultaterne som et solidt teknisk beslutningsgrundlag. Ved afgørende vurderinger bør du altid sammenholde data med billedets kontekst og fysiske logik (anatomi, lysindfald, skygger).
5. Prøv detektoren nu
Vil du teste dit første billede?
- Besøg den Gratis AI-billedetektor.
- Træk et billede ind, indsæt fra udklipsholderen eller angiv en URL.
- Se sandsynlighedsvurderingen, konfidensniveauet og åbn bevispanelet for at gennemgå de tekniske detaljer.
Referencer og videre læsning
- 01.ExifReader — Fast JavaScript image metadata parsing librarygithub.com/mattiasw/ExifReader
- 02.
- 03.Content Authenticity Initiative (CAI) — Open source provenance toolscontentauthenticity.org/
- 04.IPTC Photo Metadata Standard & Digital Source Type Vocabularyiptc.org/standards/photo-metadata/
- 05.Canvas API & ImageData — MDN Web Docsdeveloper.mozilla.org/en-US/docs/Web/API/Canvas_API
- 06.Discrete Laplace Operator in Digital Image Processing — Wikipediaen.wikipedia.org/wiki/Discrete_Laplace_operator
- 07.WebAssembly — High-performance client-side runtime standardwebassembly.org/
- 08.Google DeepMind SynthID — Imperceptible generative AI watermarkingdeepmind.google/technologies/synthid/
- 09.Stable Diffusion WebUI by AUTOMATIC1111github.com/AUTOMATIC1111/stable-diffusion-webui
- 10.ComfyUI — Powerful modular node-based Stable Diffusion GUIgithub.com/comfyanonymous/ComfyUI